
GAS × Gemini でスプレッドシート業務を自動化|コー...


Googleが読み上げ(TTS)モデル Gemini 3.8 Flash TTS と、軽量版の Gemini 3.8 Flash-Lite TTS を公開しました。発表は米国時間2026年9月23日です。
さっそく日本語で試しました。研修ナレーションや2人の掛け合い、感情の読み分け、電話自動応答の4パターンを API で生成し、この記事に音声プレーヤーで載せています。
先に結論を言うと、日本語でも声の演じ分けはかなり自在です。使い方のコツもあわせて紹介するので、音声を聴きながら読み進めてみてください。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
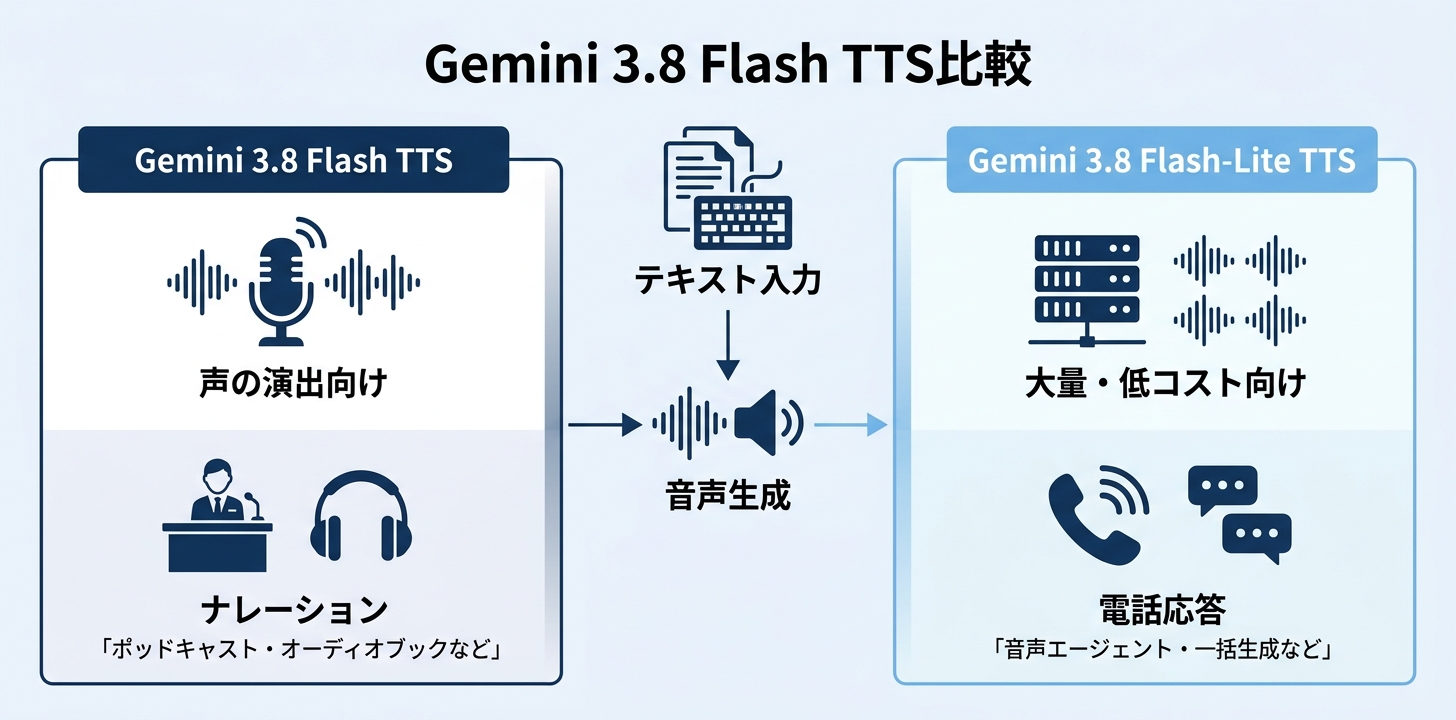
Gemini 3.8 Flash TTS は、テキストを音声に変える Google の読み上げモデルです。今回は2つのモデルが同時に公開され、Google は役割を明確に分けています*1 *2。
| Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | |
|---|---|---|
| 位置づけ | 声の演出やキャラクター設計を細かく作り込む用途 | 大量の音声を低コストでさばく用途 |
| APIのモデルID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 対応言語数(APIドキュメント) | 130言語 | 101言語 |
| 使える場所 | Gemini API/Google AI Studio/Gemini Notebook | Gemini API/Google AI Studio/Google Vids |
| Gemini Enterprise | 近日提供 | 近日提供 |
発表で挙げられている主な特徴は次の5つです*1。
評価面では、Hume AI の Voice Design Benchmark で総合1位(71.4)、アクセントの再現でも首位(60.8)を取ったと Google は発表しています。さらに Voice Arena でのブラインド評価では、日本語を含む主要言語で上位に入ったと発表しています*1。
入力できるテキストは1回あたり8,192トークンまでです*2。なお、同じ Google の音声モデルでも、こちらは読み上げ専用です。人と会話する音声対話モデルとしては、別途「Gemini 3.8 Live」が提供されています。
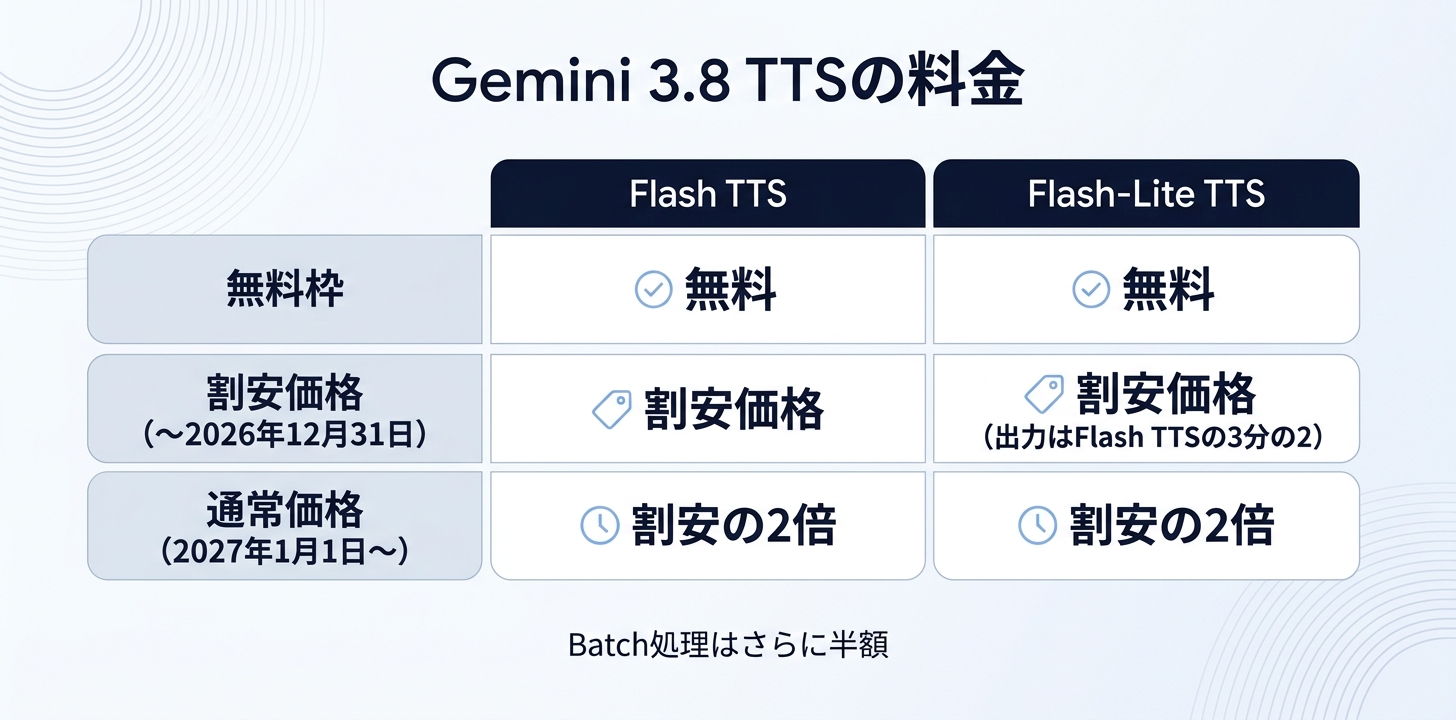
Gemini API では、Flash TTS・Flash-Lite TTS の両方に無料枠があります。有料枠の料金は、2026年12月31日までの割安価格と、2027年1月1日からの通常価格の2段階です*3。
| 100万トークンあたり | Flash TTS | Flash-Lite TTS |
|---|---|---|
| 無料枠 | 無料 | 無料 |
| 入力(テキスト)〜2026年12月31日 | $0.50 | $0.50 |
| 入力(テキスト)2027年1月1日〜 | $1.00 | $1.00 |
| 出力(音声)〜2026年12月31日 | $9.00 | $6.00 |
| 出力(音声)2027年1月1日〜 | $18.00 | $12.00 |
差が出るのは出力(音声)の単価です。Flash-Lite TTS は Flash TTS の3分の2の単価なので、電話の自動応答や大量の読み上げのように本数が多い用途では Flash-Lite TTS から検討するのが自然です。まとめて処理する Batch では、いずれもさらに半額になります*3。
社内の生成AI研修そのものを整えたい方へ。導入の流れや支援内容をまとめた資料をこちらからご覧いただけます。
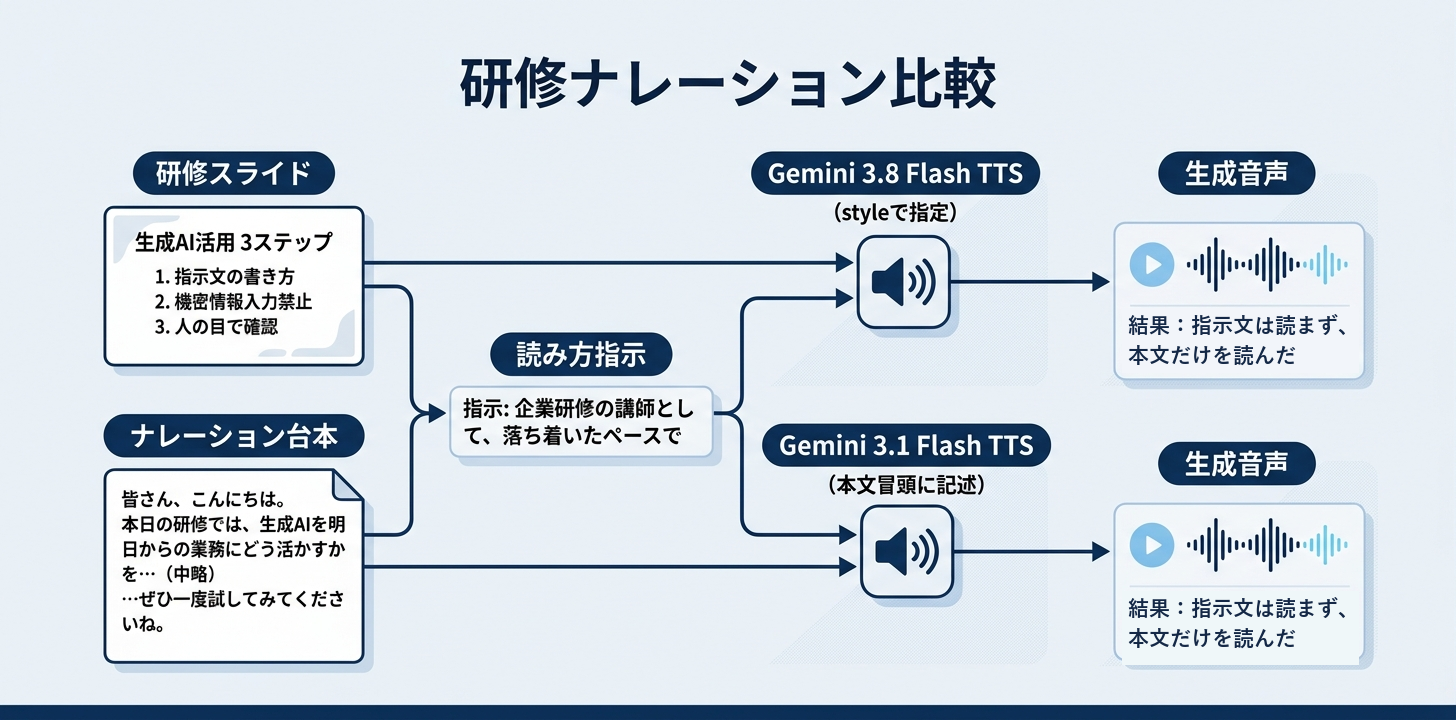
ここからは、2026年9月24日に API で実際に生成した結果です。声はすべて既成ボイスを使い、各パターン1回ずつ生成しました。
1本目は、企業研修の冒頭を想定したナレーションです。読ませた台本は次のとおりです。
皆さん、こんにちは。本日の研修では、生成AIを明日からの業務にどう活かすかを、三つのステップでお伝えします。

まず一つ目は、ChatGPTやGeminiに渡す「指示文」の書き方です。例えば、会議の議事録を要約させる場合、目的・文字数・出力形式の三点を必ず添えてください。

二つ目は、社外秘の情報を入力しないこと。そして三つ目は、出てきた答えを必ず人の目で確認することです。

10月1日の第2回までに、ぜひ一度試してみてくださいね。
同じ台本を、3.8 Flash TTS と前世代の 3.1 Flash TTS で読ませました。条件は次のとおりです。
| 3.8 Flash TTS | 3.1 Flash TTS | |
|---|---|---|
| モデルID | gemini-3.8-flash-tts | gemini-3.1-flash-tts-preview |
| 声 | Kore(女性) | Kore(女性) |
| 読み方の指示 | 「企業研修の講師として、落ち着いた聞き取りやすいペースで読み上げてください。」を style に指定 | 同じ指示を本文の冒頭に書いた |
まずは 3.8 Flash TTS です。
続いて 3.1 Flash TTS です。
音質の良し悪しは好みによる部分もあるため、ぜひ2つを聴き比べてみてください。台本の「10月1日」も「じゅうがつ ついたち」と正しく読めていました。
表の書き方の違いに気づいたでしょうか。3.1 は本文の冒頭に指示を書いても読み上げませんでしたが、3.8 に同じ書き方をすると指示文まで読み上げます。詳しくは後半の「3.8で変わった注意点」で、失敗した音声と並べて紹介します。
前世代の 3.1 Flash TTS の使い方は、以下の記事で詳しく解説しています。
Gemini 3.1 Flash TTSとは?料金・使い方・日本語ナレーション生成を徹底解説
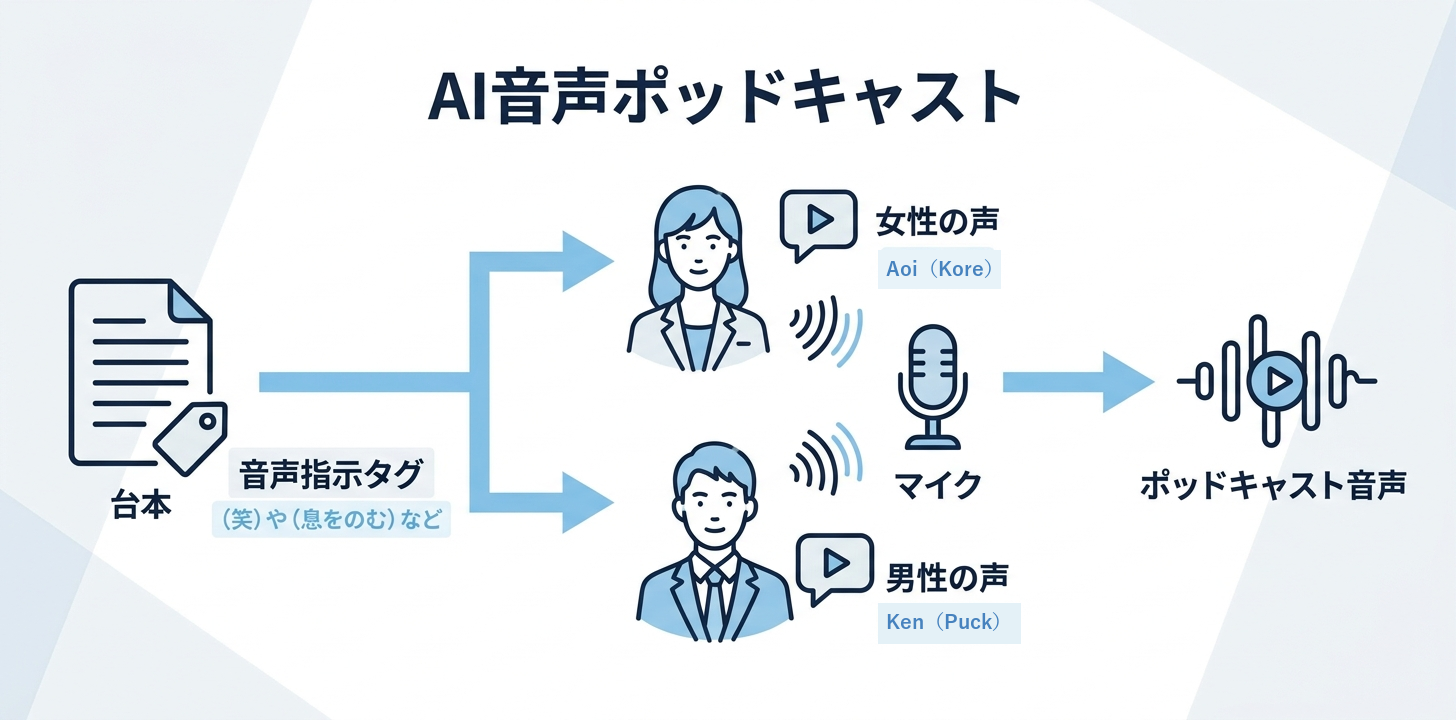
2本目は、2人でAIニュースを紹介するポッドキャスト風の掛け合いです。Aoi に女性の声(Kore)、Ken に男性の声(Puck)を割り当て、1行ごとに話者と読み方の指示を付けました。
Aoi:今週のAIニュース、始めていきましょう! Ken、今日の目玉は何?
Ken:<laugh> いきなりだね。今日はね、Googleの新しい音声モデルの話。
Aoi:へえ、声を作れるってやつ?
Ken:そうそう。文章で「落ち着いた40代の男性」みたいに書くと、その声で読んでくれるんだって。
Aoi:<gasp> それ、子どもへの絵本の読み聞かせとか、スマホの読み上げにも使えそう!
Ken:うん、まさにそこ。ただ、人の名前の読み間違いはまだあるから、大事な場面では人の耳で確認したほうがいいね。
Aoi:なるほどね。じゃあ、実際に聴き比べてみましょう。聴いてみると、2人の会話として違和感なく聞ける仕上がりでした。台本に入れたタグも、しっかりと音声に代わっておりました。
使えるタグは
実装面では、2人の掛け合いはセリフ1行ごとに話者名を付けて送る必要があります。コードは「3.8で変わった注意点」の章にまとめています。
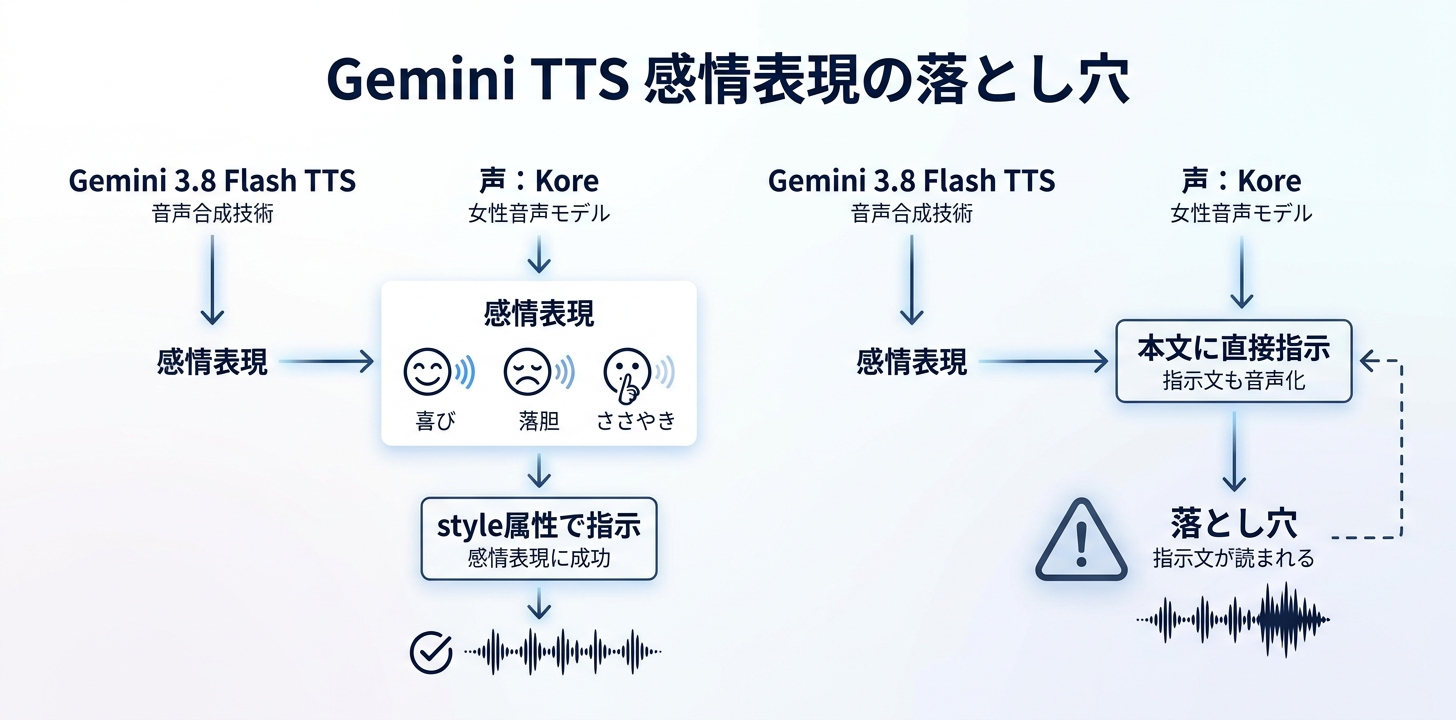
3本目は、ほぼ同じセリフを3通りの感情で読ませるテストです。声は Kore(女性)で、1行ずつ style に読み方の指示を付けました。
| セリフ | style に書いた指示 |
|---|---|
| 企画書、通りました! | とてもうれしそうに、声を弾ませて |
| 企画書、通りませんでした……。 | がっかりして、ため息まじりに |
| ここだけの話、企画書、通りましたよ。 | ささやき声で、内緒話のように |
正直、ここまで声色を変えられるのかと驚きました。弾んだ声、落ち込んだ声、ささやき声の違いがはっきり出ているので、ぜひ聴いてみてください。
今だけ12大特典を無料プレゼント中。ChatGPTやGeminiの実践テクニックをまとめた限定コンテンツを、LINE登録だけでお届けしています。
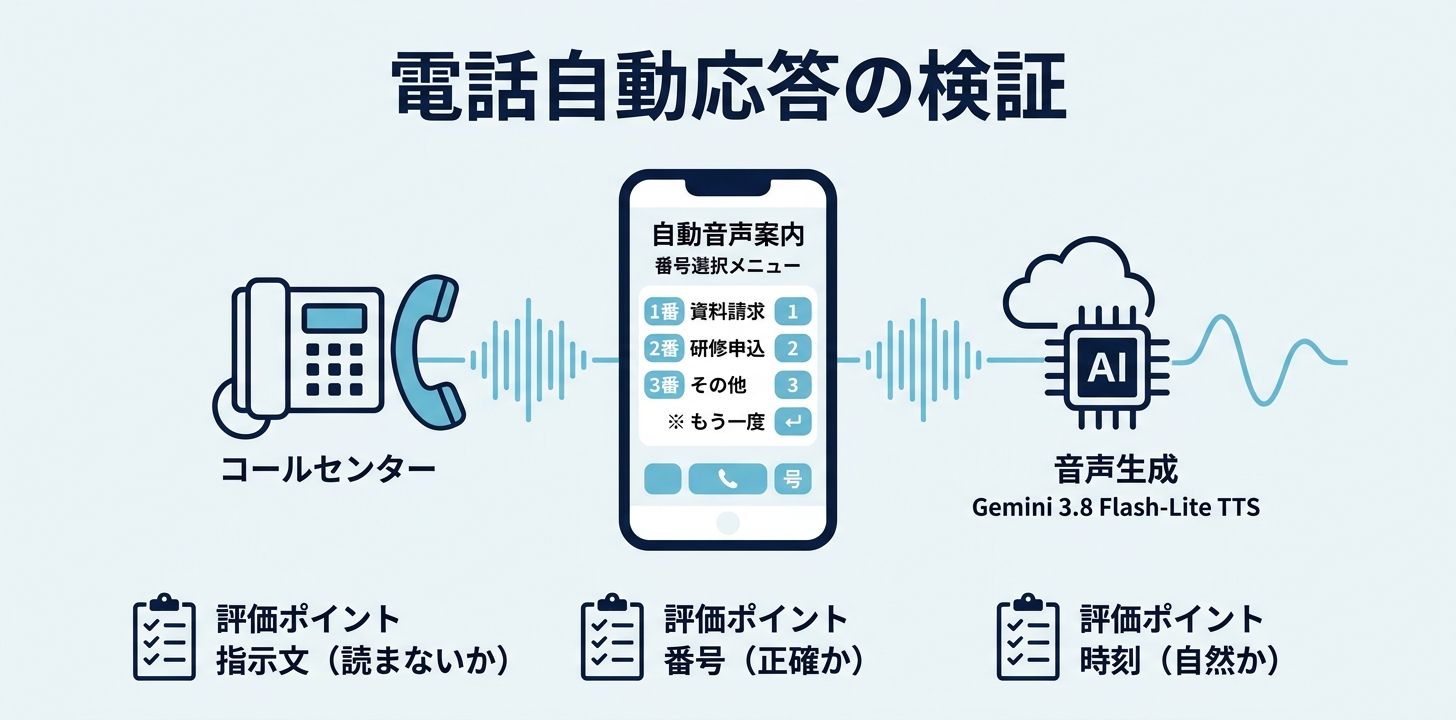
4本目は大量生成向けの Flash-Lite TTS です。用途として一番想定しやすい、電話の自動音声案内を読ませました。会社名は架空の「サンプル商事」です。
お電話ありがとうございます。サンプル商事、カスタマーサポートセンターです。

ご用件に応じて、番号を押してください。資料のご請求は1番、研修のお申し込みは2番、それ以外のお問い合わせは3番を押してください。

もう一度お聞きになる場合は、米印を押してください。

受付時間は、平日の午前9時から午後6時までです。
声は Aoede(女性)、style には「電話の自動音声案内として、丁寧で聞き取りやすく」と書きました。
確認したポイントは次の3つです。
style に書いた指示は読まれず、本文だけが読まれたリアルタイムに人と会話する音声エージェントを作りたい場合は、読み上げ専用の TTS ではなく音声対話モデルの出番です。Google の音声対話モデル Gemini 3.8 Live については、以下の記事で解説しています。
Gemini 3.8 Liveが来た|Gmailやドキュメントの中でAIと「話しながら」仕事をする
5本目は、読み間違いが起きやすい要素を詰め込んだ台本です。声は Charon(男性)で、読み方の指示は付けていません。
営業部の東海林さんと、経理の服部さんが、日本橋の本社で打ち合わせをします。

日時は2026年9月24日、午後3時15分から。見積金額は1,280万円で、前年比12.5%の増加です。

資料はPDFとExcelで共有し、詳しくはdigirise.aiに掲載しています。

なお、今日は生憎の雨ですが、生の声を大切に、一日一日を積み重ねていきましょう。
結果は次のとおりです。
| 読ませた語 | 結果 |
|---|---|
| 東海林 | 「しょうじ」と読めず、別の読みになった |
| 日本橋 | 「にほんばし」と正しく読めた |
| 生憎 | 「あいにく」と正しく読めた |
| 一日一日 | 「いちにちいちにち」と正しく読めた |
| 1,280万円/12.5% | 正しく読めた |
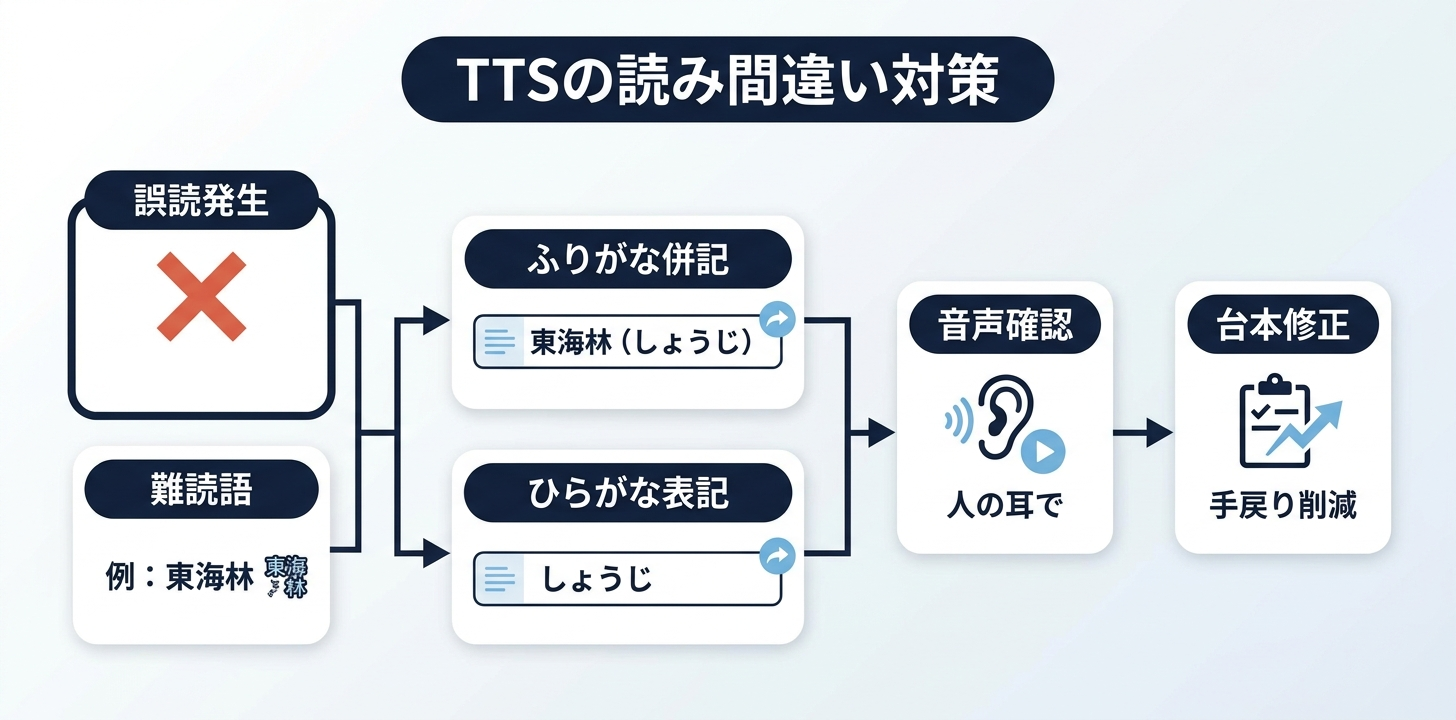
読み間違えたのは「東海林」だけでした。
そこで、対処として2通りの書き方を試しました。
聴いてみると、どちらの書き方でも「しょうじ」と読めていました。ただ、イントネーションは不自然なままです。難読の名字なので、ここはある程度しかたがないと感じました。
人名や社名のように間違えると失礼になる語は、生成した音声を必ず人の耳で確認してください。確実に読ませたい語は、最初からふりがなを併記するかひらがなで台本に書いておくと手戻りを防げます。
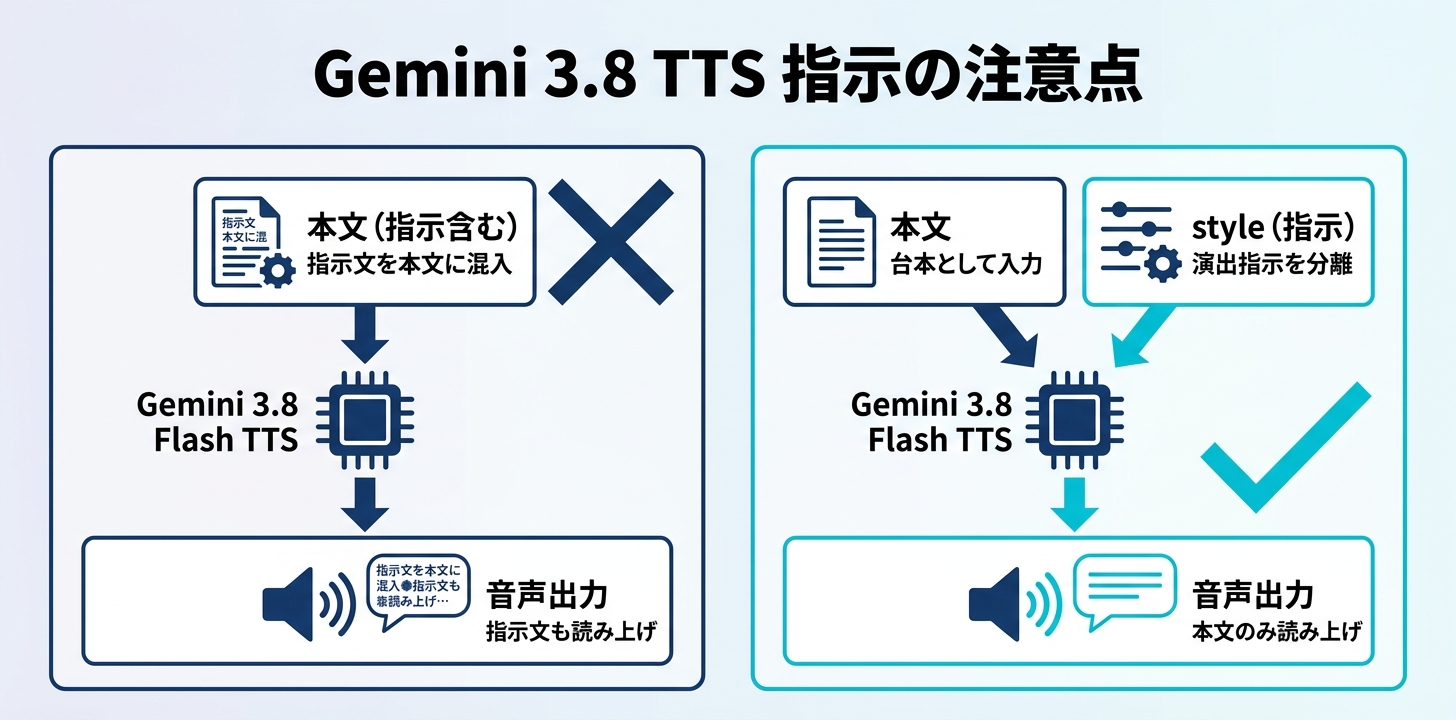
この記事で一番伝えたいのがここです。Gemini 3.8 の TTS は、入力したテキストを一字一句そのまま読む台本として扱います。「落ち着いたペースで」のような演出の指示は、本文ではなく speech_metadata の style に分けて渡す仕様です*4。
研修ナレーションの冒頭に指示文を書いた音声を聴くと、違いが明確に分かります。
同じ指示を style に移した版が、研修ナレーションの章で紹介した音声です。3通りの書き方を比べると、次のようになりました。
| 指示の書き方 | 3.8 Flash TTS の結果 |
|---|---|
| 本文の冒頭に指示文を書く | 指示文まで読み上げた |
| 本文に角かっこのト書きを書き、「読み上げないで」と添える | ト書きも「読み上げないで」の一文も読み上げた |
指示を style に分ける | 本文だけを読んだ |
前世代の 3.1 Flash TTS に本文冒頭に指示を入れて読ませていたプロンプトやコードは、3.8 にモデルを差し替えるだけでは同じ結果になりません。移行するときは、指示の置き場所を style に移してください。
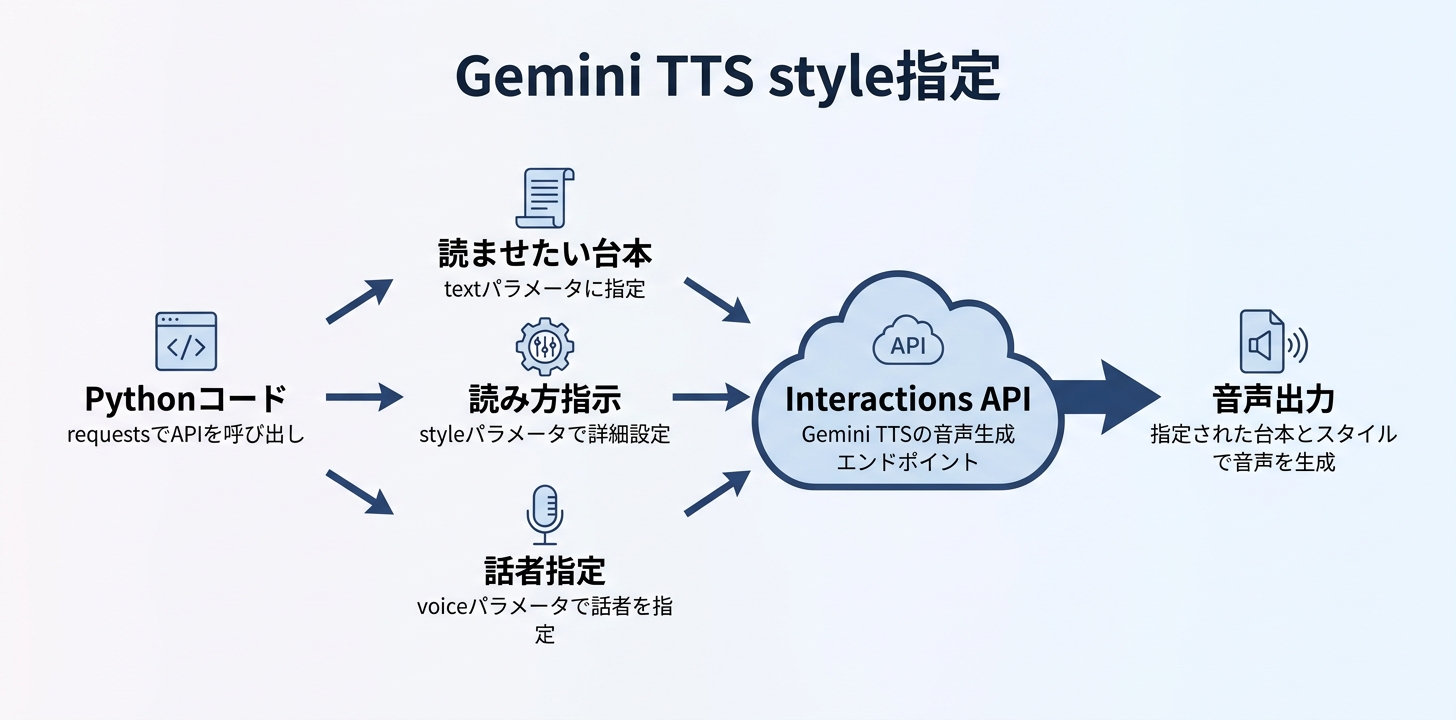
style は、従来の generate_content でも、新しい Interactions API(https://generativelanguage.googleapis.com/v1beta/interactions)でも指定できます*4。
以下は私たちが実際に動かした Interactions API の例で、Python の requests で直接呼んでいます。APIキーは環境変数 GEMINI_API_KEY から読みます。
import base64, os, requests

API_KEY = os.environ["GEMINI_API_KEY"]
URL = "https://generativelanguage.googleapis.com/v1beta/interactions"

body = {
    "model": "gemini-3.8-flash-tts",
    "input": [{
        "type": "user_input",
        "content": [{
            "type": "text",
            # 本文には「読ませたい台本」だけを書く
            "text": "皆さん、こんにちは。本日の研修では、生成AIを明日からの業務にどう活かすかを、三つのステップでお伝えします。",
            # 読み方の指示は style に分ける
            "annotations": [{
                "type": "speech_metadata",
                "style": "企業研修の講師として、落ち着いた聞き取りやすいペースで",
            }],
        }],
    }],
    "response_format": {"type": "audio"},
    # 1人読みは voice だけを指定する
    "generation_config": {"speech_config": [{"voice": "Kore"}]},
}

r = requests.post(URL, headers={"x-goog-api-key": API_KEY}, json=body, timeout=300)
r.raise_for_status()

# レスポンスの中から base64 の音声データを探して保存する
def find_audio(o):
    if isinstance(o, dict):
        if isinstance(o.get("data"), str) and len(o["data"]) > 1000:
            return o["data"]
        for v in o.values():
            if (x := find_audio(v)):
                return x
    elif isinstance(o, list):
        for v in o:
            if (x := find_audio(v)):
                return x

with open("narration.wav", "wb") as f:
f.write(base64.b64decode(find_audio(r.json())))1人読みの場合、annotations には style だけを書きます。話者名(speaker)を使うのは、次の2人の掛け合いのときです。
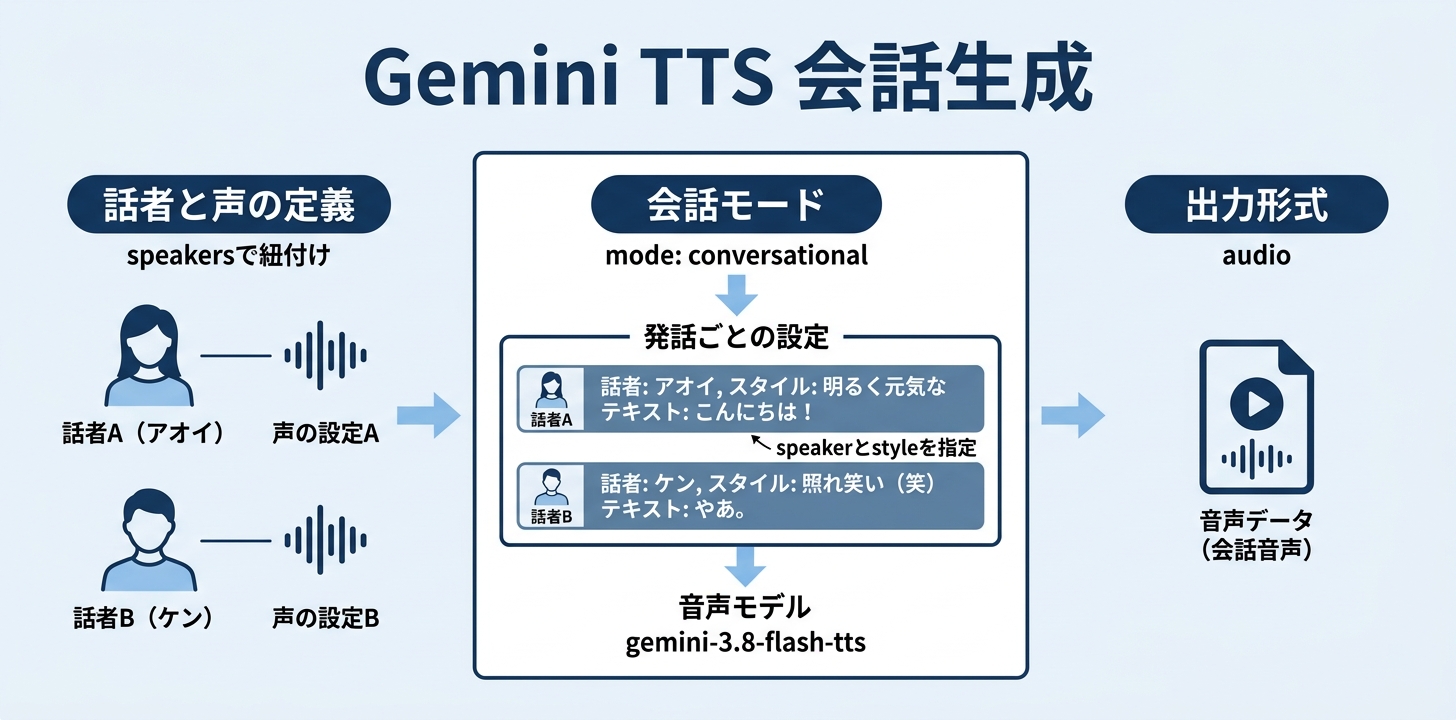
2人の掛け合いは、speech_config に "mode": "conversational" と話者と声の対応を渡し、各行の annotations に speaker と style を書きます。
import base64, os, requests

API_KEY = os.environ["GEMINI_API_KEY"]
URL = "https://generativelanguage.googleapis.com/v1beta/interactions"

lines = [
    ("Aoi", "明るく、番組の始まりらしく元気に", "今週のAIニュース、始めていきましょう! Ken、今日の目玉は何?"),
    ("Ken", "少し照れ笑いしながら、くだけた口調で", "<laugh> いきなりだね。今日はね、Googleの新しい音声モデルの話。"),
    ("Aoi", "興味津々に", "へえ、声を作れるってやつ?"),
]

body = {
    "model": "gemini-3.8-flash-tts",
    "input": [{
        "type": "user_input",
        "content": [
            {"type": "text", "text": text,
             "annotations": [{"type": "speech_metadata", "speaker": speaker, "style": style}]}
            for speaker, style, text in lines
        ],
    }],
    "response_format": {"type": "audio"},
    "generation_config": {"speech_config": {
        "mode": "conversational",
        "speakers": [
            {"speaker": "Aoi", "voice": "Kore"},
            {"speaker": "Ken", "voice": "Puck"},
        ],
    }},
}

r = requests.post(URL, headers={"x-goog-api-key": API_KEY}, json=body, timeout=300)
r.raise_for_status()
# 音声データの取り出しは1人読みの例と同じ find_audio() を使う
実装するときは、次の2点も押さえておくとスムーズです。
speech_metadata に話者名を書きます。この形なら、従来の generate_content でも掛け合いを作れます*5google-genai 2.3.0 以降 — それより古い SDK では使えないので、SDK を更新するか、上の例のように REST を直接呼びます*6ここまで読んで「電話の自動応答や社内の音声案内に組み込めそうだ」と感じた方へ。法人向けAI研修の導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
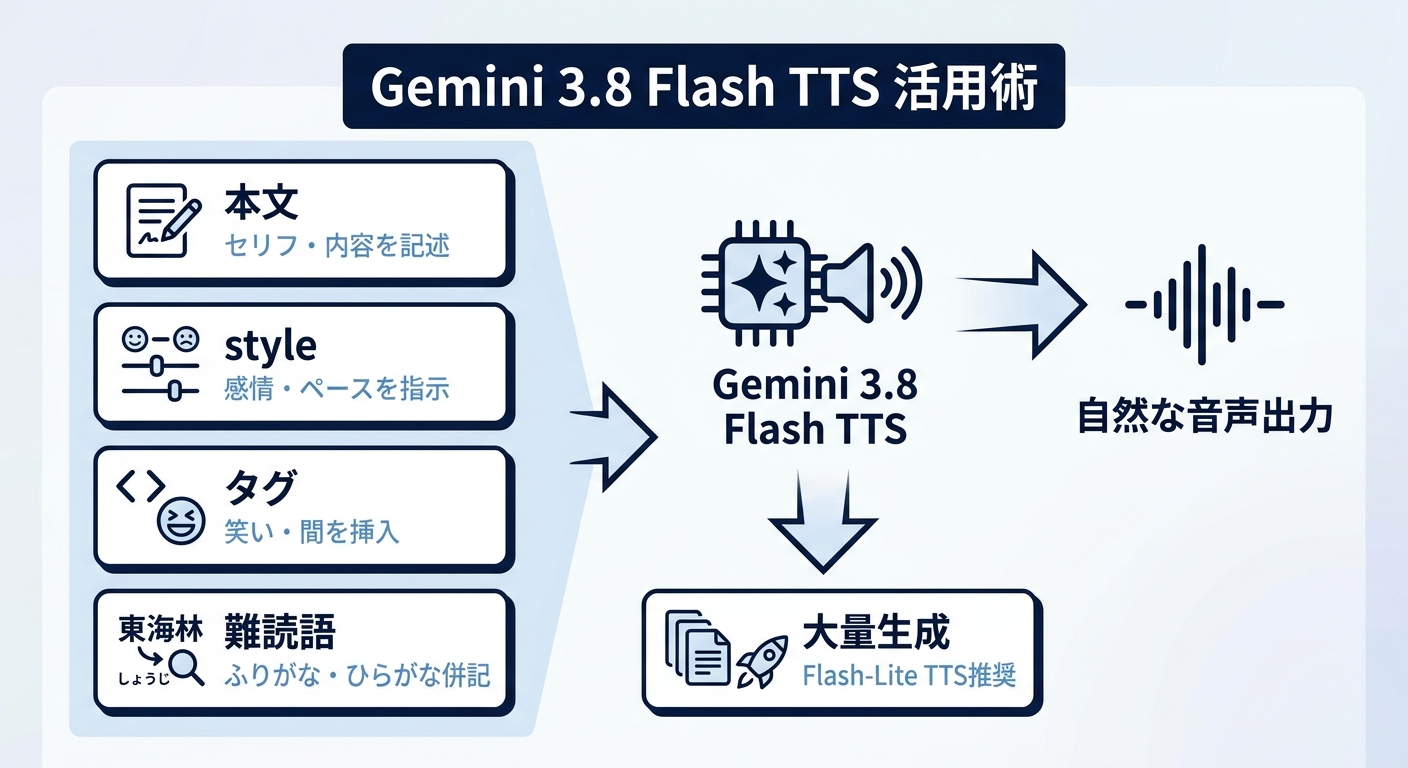
Gemini 3.8 Flash TTS を日本語で試して分かったことをまとめます。
style に分ける — 本文に書いた指示文は、3.8では読み上げられてしまう。感情やペースは style、笑い声や間は 前世代の 3.1 から乗り換える場合も、まずは指示の置き場所を style に移すところから始めてみてください。声の演じ分けは文章の指示だけでかなり細かく変えられるので、動画のナレーションや音声案内、文章の読み上げなど、身近な用途で一度試してみるのがおすすめです。
\AIを活用したノウハウが詰まった/ 資料ダウンロードはこちら