
Claudeとは?日本の利用は世界32位|企業導入の壁と活用事...


2026年11月9日、Anthropicが新モデル「Claude Fable 5.2」を公開しました*1。API料金は入力100万トークンあたり8ドル・出力40ドルで、9月に出たClaude Opus 5.5(入力4ドル・出力20ドル)のちょうど2倍です*3。Claude Codeでもすぐに選べるようになったので、私はAPIで同じ課題を両モデルに投げ、effort(考える深さ)の設定を変えながら費用と時間を比べてみました。
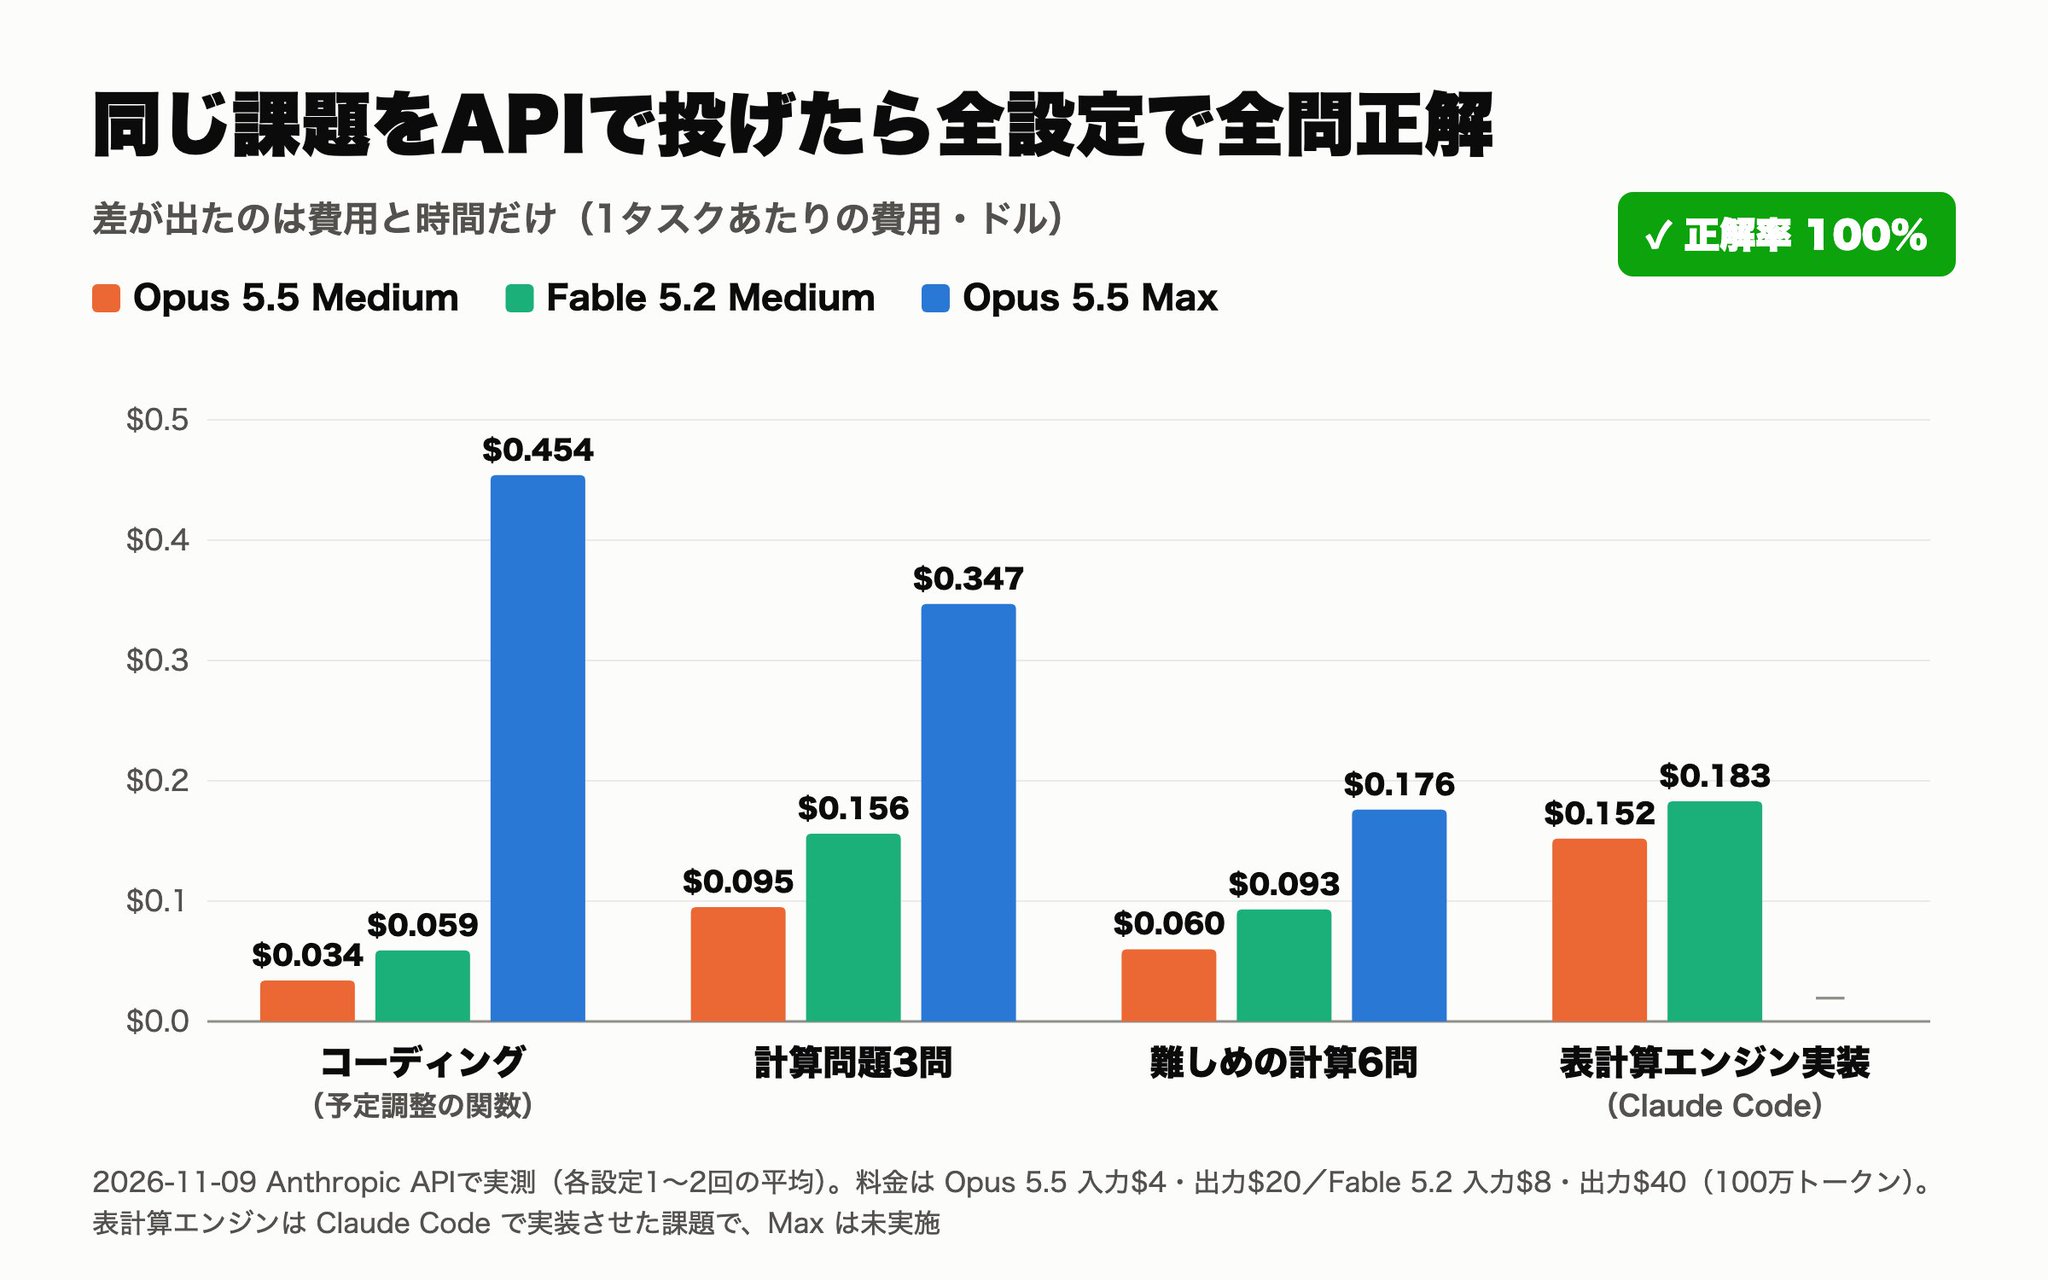
課題はコーディング、計算問題、Claude Codeでの表計算エンジン実装など4種類です。先に結論を言うと、どの設定も全問正解で差が出たのは費用と時間だけでした。普段の仕事ならClaude CodeはOpus 5.5のMediumで十分で、Fable 5.2やMaxはOpusで解けない難所に絞るのが費用対効果の高い使い方です。
この話題は、私もXで紹介しました。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
Claude Codeは、Anthropicが提供するAIコーディングエージェントです。ターミナルやデスクトップアプリから指示を出すと、Claudeがファイルを読み、コードを書き、コマンドを実行しながら作業を進めます。使うモデルとeffortはユーザーが選べるので、同じ作業でも設定しだいで費用と待ち時間が大きく変わります。
Anthropicの公式ドキュメントでは、Pro・Max・Team・EnterpriseプランやAPIでのClaude Codeの標準モデルはOpus 5.5です。一方でFableはどのプランでも標準にはならず、使うときは明示的に選ぶ必要があります*6。今回比べた2モデルの位置づけを表にまとめます。
| 項目 | Claude Opus 5.5 | Claude Fable 5.2 |
|---|---|---|
| 公開日 | 2026年9月22日 | 2026年11月9日 |
| 公式の位置づけ | 長時間のエージェント型コーディングと知的作業向け | 高度な推論と長時間のエージェント作業向け |
| API料金(100万トークン) | 入力4ドル/出力20ドル | 入力8ドル/出力40ドル |
| APIの標準effort | medium | high |
| Claude Codeの標準effort | medium | medium |
| コンテキスト長/最大出力 | 100万トークン/12.8万トークン | 100万トークン/12.8万トークン |
| Claude Codeでの呼び出し | /model opus | /model fable |
公式のモデル一覧には「迷ったらまずOpus 5.5から始め、Opus 5.5のeffortを上げても評価に届かないときにFable 5.2を使う」という趣旨の案内があります*4。今回の比較は、この案内が実際の課題でも当てはまるのかを自分で確かめる目的で行いました。
なおAnthropicはOpus 5.5について「ほとんどの仕事でFable 5.1と同等の水準」と説明しています*2。Fable 5.2はそこからさらに上を狙ったモデルで、発表ではエージェント型コーディングのベンチマークFrontierSWE v2でFable 5.2が69.9%、Opus 5.5が62.3%とされています*1。ベンチマークでは差がある2モデルが、日常的な課題でどこまで差を見せるのかが今回の焦点です。
比較ではAPIから同じプロンプトを送り、モデルとeffortの組み合わせを変えて正解数・費用・処理時間を記録しました。課題はコーディング、計算問題、Claude Codeでの表計算エンジン実装など4種類です。表計算エンジンは、セルの参照や数式の計算をこなす小さなプログラムをClaude Codeにゼロから書かせるもので、実務の小規模な開発に近い課題として入れました。
| 観点 | 結果 |
|---|---|
| 正解数 | どのモデル・どのeffortでも全問正解 |
| Opus 5.5 MediumとFable 5.2 Mediumの費用 | Opus 5.5はFable 5.2の6〜8割 |
| Opus 5.5 Max | 同じ正解に最大13倍の費用、時間は200秒超 |
| Claude Codeでの表計算エンジン実装 | Opus 5.5が約50秒、Fable 5.2が約70秒 |
一番大きな発見は、どの設定でも答えが変わらなかったことです。答えが同じなら、選ぶ基準は費用と待ち時間しか残りません。その2つの軸で見ると、Opus 5.5のMediumがもっとも無駄の少ない設定でした。
Opus 5.5の単価はFable 5.2のちょうど半分です*3。同じトークン数で解けば費用も半分になるはずですが、実測ではFable 5.2の6〜8割でした。つまりOpus 5.5のほうが同じ課題により多くのトークンを使っていたと見られます。
上位モデルは少ない試行で答えにたどり着き、下位モデルは考える量や手数が増える傾向があります。それでも単価の差がトークン量の差を上回ったため、結果としてOpus 5.5が安く済みました。単価だけで「半額」と見積もると実際の差を見誤るので、費用の比較は実際の課題で測るのがおすすめです。
Opus 5.5をMaxにすると、同じ正解を得るのに最大13倍の費用がかかり、処理時間も200秒を超えました。今回の課題はMediumで解けていたので、Maxで増えた思考はほとんど結果に結びつかなかったことになります。
公式ドキュメントもFable 5.2について、maxはモデルの上限を測るときや時間と費用を気にしないまれな課題に使うものとし、xhighより遅く高い割に「小さな向上にとどまることが多い」と説明しています*5。effortを上げれば考える量は増えますが、課題がすでに解ける水準にあるなら費用が増えるだけです。
表計算エンジンの実装はOpus 5.5が約50秒、Fable 5.2が約70秒で終わりました。どちらも正しく動くものを作れたので、この差はそのまま待ち時間の差になります。1回の20秒は小さく見えますが、Claude Codeで1日に何十回も指示を出す使い方では積み重なって効いてきます。
公式の一覧では2モデルの応答速度はどちらも「Moderate(中程度)」とされており、実際の速さはプロンプトの長さや出力量、effortで変わります*4。今回の結果はあくまで私の課題での傾向として受け止めてください。
APIやClaude Codeを従量課金で使う場合、費用は「モデルの単価×トークン量」で決まります。effortはトークン量を、モデルと高速モードは単価を動かすと考えると整理しやすくなります。公式の料金表から主要な項目を抜き出しました*3。
| 料金(100万トークンあたり) | Claude Opus 5.5 | Claude Fable 5.2 |
|---|---|---|
| 通常の入力/出力 | 4ドル/20ドル | 8ドル/40ドル |
| Batch API(非同期・50%割引) | 2ドル/10ドル | 4ドル/20ドル |
| 高速モード(fast mode) | 8ドル/40ドル | 16ドル/80ドル |
| キャッシュ読み込み | 0.20ドル | 0.20ドル |
目安として、入力100万トークン・出力20万トークンの作業を通常料金で処理すると、Opus 5.5は4ドル+4ドルで8ドル、Fable 5.2は8ドル+8ドルで16ドルです。ここに先ほどのトークン量の差が加わるので、実際の差は2倍より小さくなります。それでもチーム全体で毎日使えば、月単位では無視できない金額になります。
目を引くのは、Opus 5.5の高速モードがFable 5.2の通常料金と同じ単価だという点です。急ぎの作業で速さが欲しいなら、Fableに切り替えるよりOpusの高速モードを試すほうが合う場面もあると見られます。一方で急がない大量処理はBatch APIに回せば半額になります。
ProやMaxなどのサブスクリプションでClaude Codeを使う場合は、費用ではなく利用上限の減り方として差が表れます。AnthropicはFable 5.2について、ProプランとTeamの標準シートでは週の利用上限の最大50%までFableを使えると説明しています*1。普段からFableを使うと上限に早く届くので、ここでも「普段はOpus」の考え方が効いてきます。
AnthropicはOpus 5.5の公開にあわせて、Pro・Max・Team・シート制Enterpriseプランの5時間あたりの利用上限を引き上げたとも発表しています*2。上限に余裕のあるOpusを日常の作業に使い、Fableの枠は本当に必要な作業のために残しておくのが現実的な配分です。
Claude Codeを自社の開発フローに組み込みたい方や、モデル選びと費用管理まで含めて設計したい方もいるかと思います。法人向けAIリスキリングサービスの導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
Claude Codeでは、モデルとeffortを作業の途中でも切り替えられます。公式ドキュメントに載っている主な方法は次の通りです*6。
/model — セッション中にモデルを切り替えるコマンド。/model opus や /model fable のように別名で指定でき、引数なしなら選択画面が開きます/effort — effortを変えるコマンド。引数なしでスライダーが開き、/effort high のように直接指定もできます。/effort auto で保存した設定を解除します--model/--effort — 起動時に指定するオプション。そのセッションだけ設定を変えたいときに使いますCLAUDE_CODE_EFFORT_LEVEL — effortを固定する環境変数。ほかのどの設定よりも優先されますmodel や effortLevel で既定値を保存できます。ただし設定ファイルでは max を指定できません選択画面ではEnterで切り替えると既定値として保存され、sキーならそのセッションだけに適用されます*6。普段はOpus 5.5のMediumを既定にしておき、難しい作業のときだけsキーでFableや高いeffortに一時的に切り替える運用がおすすめです。Fable 5.2を使うにはClaude Code v2.1.321以降が必要なので、選べないときは claude update で更新してください。
チームで使う場合は、環境変数で設定を固定すると個人の判断で高い設定に切り替えられなくなる点に注意が必要です。全員の既定値をそろえたいなら設定ファイルで共有し、難しい作業のときだけ各自が /model で切り替えられる余地を残しておくと運用しやすくなります。
ChatGPTやCopilotなどほかのツールも含めたeffortの考え方は、以下の記事で解説しています。
AIの「Effort」設定とは?ChatGPT・Claude・Copilot・Geminiで処理の深さを使い分ける方法
今回の結果と公式ドキュメントの推奨をもとに、私ならどの作業にどの設定を使うかを表にしました。社内で「どのモデルを使えばいいのか」と聞かれたときの目安にしてください。
| 業務 | おすすめの設定 | 理由 |
|---|---|---|
| 社内ツールの小さな改修・スクリプト作成 | Opus 5.5/Medium | 今回の実装課題と同じ規模。正解できて速く安い |
| Excel・CSVの集計や変換処理 | Opus 5.5/Low〜Medium | 手順が明確な作業は低いeffortでも品質を保ちやすい |
| 既存コードの調査・不具合の原因探し | Opus 5.5/High | ファイルをまたいで読む量が多く、手数を惜しまないほうがよい |
| 数時間かかる大規模な改修や移行 | Fable 5.2/High〜xhigh | 公式もxhighは30分を超える長時間の作業向けとしている |
| Opusで何度やっても解けない難問 | Fable 5.2 | 公式の案内どおり、Opusで届かないときの切り札にする |
| 急ぎの修正 | Opus 5.5/高速モード | Fableに替えるより単価を抑えて速さを得られる |
表の考え方をひと言でまとめると「答えが出るなら一番安い設定を選び、出ないときだけ上げる」です。公式ドキュメントでもxhighは30分を超える長時間のエージェント作業や数百万トークン規模の作業向けと説明されており、日常の数分で終わる作業には過剰です*5。
この考え方を社内に広めるなら、細かい表を配るより段階を決めておくほうが定着しやすいと感じます。私がおすすめするのは次の3段階です。
第3段階で理由を記録しておくと、どの業務にFableが必要だったのかが社内に蓄積されます。数か月たてば、自社でFableを使うべき業務の一覧ができ、費用の見通しも立てやすくなります。
非エンジニアの方がClaude Codeで業務を効率化した具体例は、以下の記事で10個紹介しています。
【実践編】Claude Codeの活用事例10選|非エンジニアでも業務が10倍速になる使い方
今回の比較は私の4種類の課題での結果で、どんな業務でもOpus 5.5で足りると言い切れるものではありません。社内で標準設定を決める前に、次の点を確認しておくと安心です。
max_tokens を大きめにしないと途中で止まることがありますとくにデータ保持の条件は、情報システム部門や法務の確認が必要になるポイントです。Opus 5.5で業務が回るなら、Fableの利用は対象業務を絞って申請するほうが社内調整も進めやすいと思います。
Opus 5.5の性能や4モデルの実機比較は、以下の記事で解説しています。
Claude Opus 5.5とは?料金・性能・effortの選び方と4モデル実機比較
Fableシリーズがどんな位置づけで登場したのかは、以下の記事で解説しています。
Claude Fable 5とは?Mythos級が初めて一般公開|性能・料金・実際に使った所感まで
/model と /effort で切り替えられ、普段はOpus 5.5のMediumを既定にするのが効率的です新しい上位モデルが出ると全部をそちらに切り替えたくなりますが、答えが同じなら安くて速いほうを選ぶのが仕事の道具としての賢い使い方です。私のおすすめは、Claude Codeの既定をOpus 5.5のMediumにしたうえで、自社の代表的な課題を3〜5個用意して一度だけ同じ比較を試してみることです。結果が数字で見えれば、Fableをどこで使うかのルールも社内で決めやすくなります。
\AIを活用したノウハウが詰まった/
資料ダウンロードはこちら記事の検索結果をご案内します。詳しいご相談は担当者がお答えします