
dotsで商談準備を自動化する方法|30分前に準備レポートが届...


AIが書いた数学の論文が、700本以上まとめて公開されました。OpenAIが2026年10月6日付で発表したもので、社内の未公開モデルが生み出した論文722本(成果のまとまりで372件)を、GitHubで誰でも読める形にしています*1 *2。
論文を生成したのは、一般にはまだ公開されていない社内モデルです。相当性能が高そうなので、私は次のモデルが楽しみです。ただし、検証やレビューが一部終わらないまま公開されており、真偽の判定はこれからです。
実際、公開の翌日(10月7日付)には3本の論文を取り下げ、14本を改訂しています*3。この記事では、何が公開されたのか、9月のナビエ–ストークス方程式の発表との関係、まだ分からないことを整理し、あなたの仕事にどう関係するかまで書いていきます。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
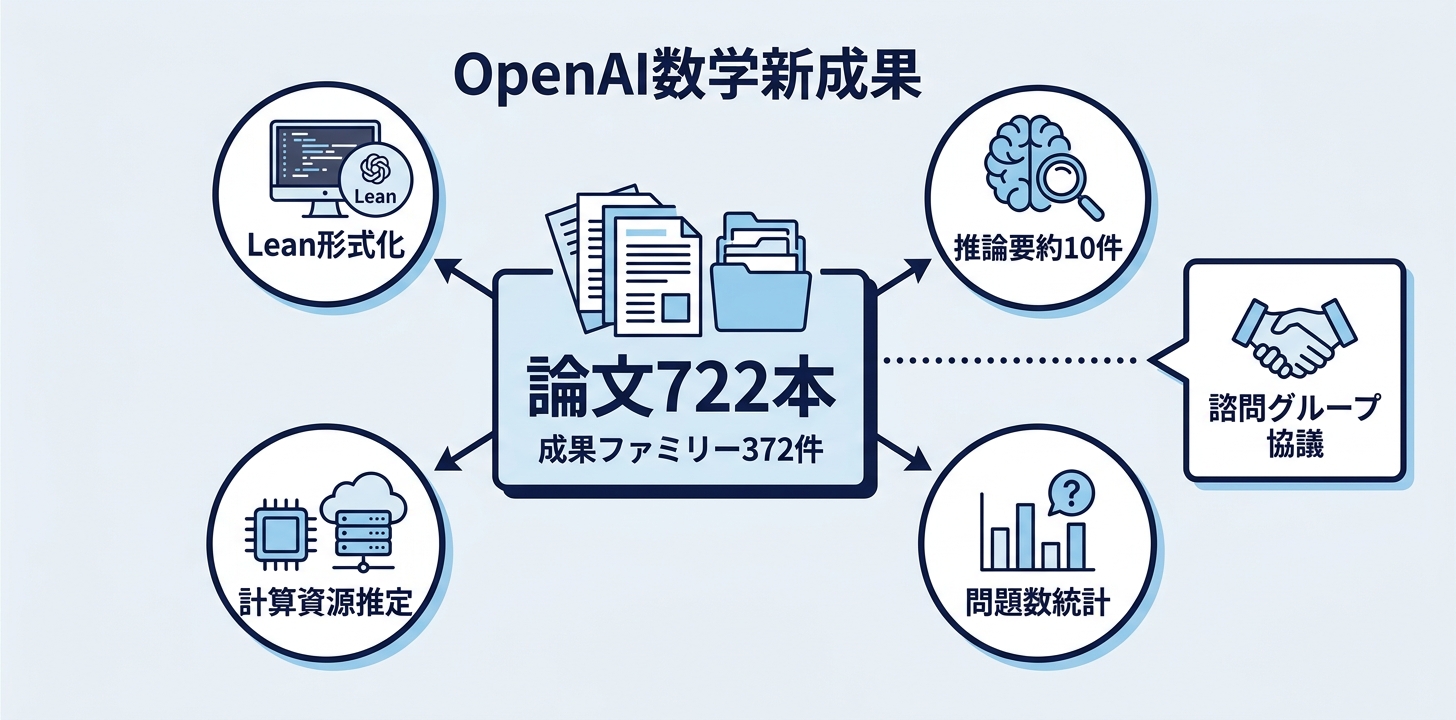
OpenAIが公開したのは、社内のフロンティアモデルが生み出した、数学の幅広い新しい成果です。論文に加えて、証明をコンピューターで確かめるための資料や、モデルの考え方の要約もあわせて出しています。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年10月6日付 |
| 公開したもの | 数学の論文(公開時722本・成果ファミリー372件)と、それを支える証明の資料 |
| 生み出したモデル | 一般には公開されていない社内のモデル |
| 公開先 | GitHubのリポジトリ「openai/math」(ライセンスはApache-2.0) |
| あわせて公開したもの | Leanによる証明の形式化、推論の要約10件、計算資源の推定値、解答を試みた問題数の統計 |
| 公開方法の相談先 | 高等研究所の数学・人工知能諮問グループ(AGMAI) |
Leanは、証明が正しいかどうかをコンピューターで検証できるプログラミング言語です。論文の証明を、コンピューターが一歩ずつチェックできる形に書き直すことを「形式化」と呼びます。
OpenAIは、モデル開発の一環として、未解決の研究問題でモデルを評価しています。既存の数学の評価で性能が頭打ちになったため、未解決問題にまで対象を広げました。今回の論文は、その評価の中から出てきた成果です。
公開にあたってOpenAIは、AI企業に数学界との関わり方を助言する独立した諮問グループと協議し、出された助言や提言を公開方法に反映させたとしています。論文の改訂や引用のルールを決めたうえで、GitHubで公開しました。
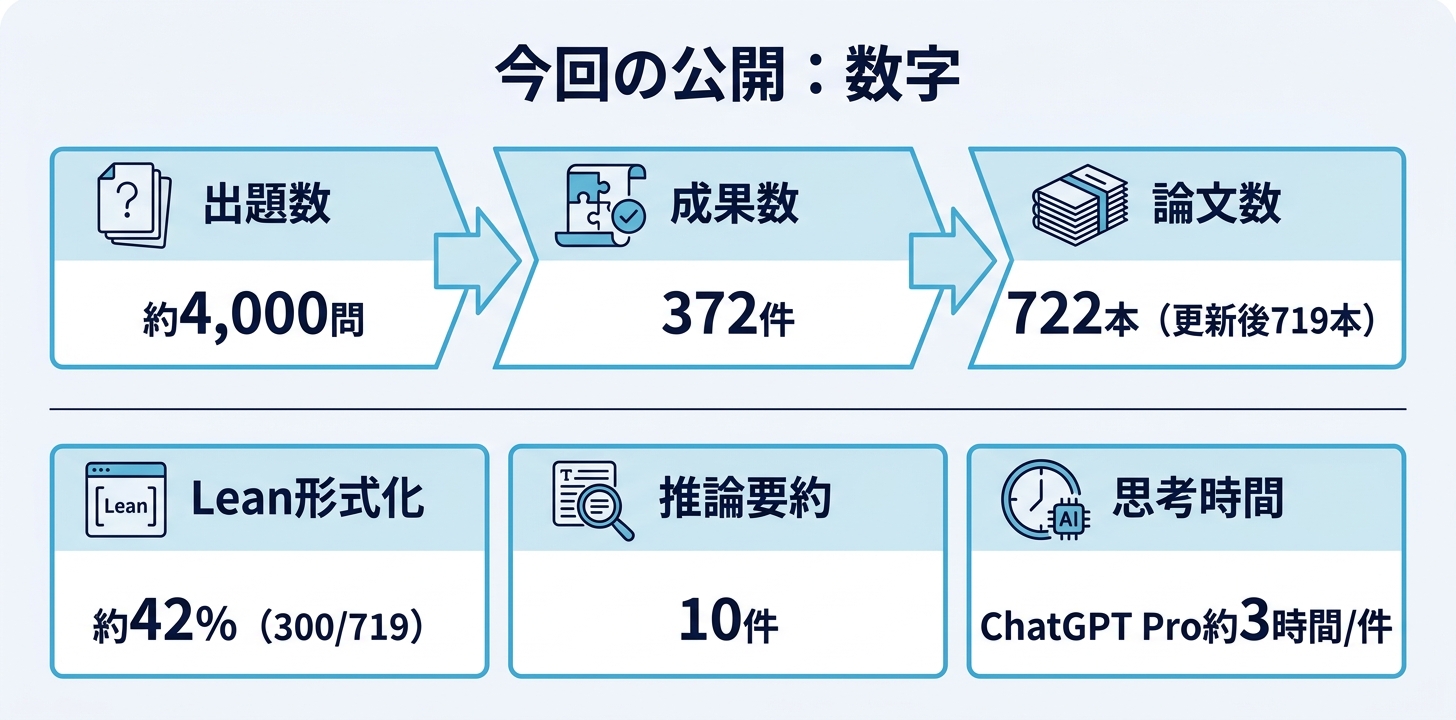
今回の公開を数字でまとめると、次のとおりです。
| 項目 | 数字 |
|---|---|
| 論文 | 公開時722本。10月7日付の更新で3本を取り下げ、更新後は719本 |
| 成果ファミリー | 372件 |
| モデルに出した問題 | 約4,000問 |
| 成果1件あたりの計算資源 | 平均でChatGPT Proの思考時間の約3時間分 |
| Leanで形式化された主要な結果 | 300 / 719(約42%)※10月7日付の更新後 |
| 推論の要約の公開 | 10件 |
成果ファミリーは、主要な結果と、それに関連する論文・そこから導かれる結果・別の証明などをひとまとめにした単位です。ファミリーごとに、数学の分野で分類されています。論文の本数がファミリーの数より多いのは、1つの成果に複数の論文が付いているためです。
評価の過程で、モデルには約4,000問が出題されました。その出力をファミリーと論文にまとめ、一定の重要度を満たすものに絞ったのが今回の一覧です。大半の結果は、同じ手順・同じ未公開モデルで得られています。
決まった手順の例外として挙げられているのは、次の2つです。
このうち、Re(s) > 11/12 の零点なし領域についての文書は、読みやすくするために人間が編集しています。
モデルがどのような思考過程で結論に至ったのか、次の10件について要約が公開されています。
「まずは何ができるか知りたい」といった情報収集段階でのご相談も大歓迎です。導入の流れや具体的な支援内容をまとめた資料を以下よりご覧いただけますので、ぜひお気軽にご活用ください。
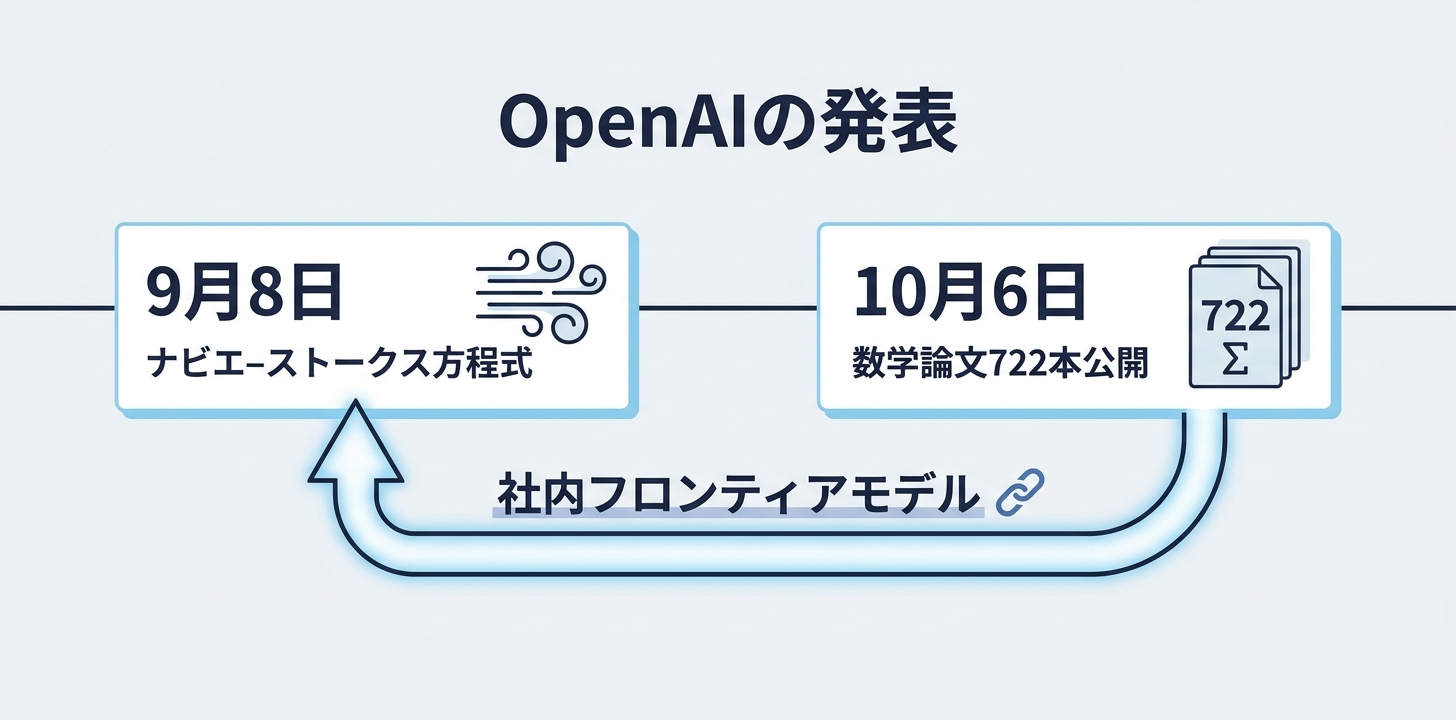
OpenAIは今回の発表に先立つ2026年9月8日に、ナビエ–ストークス方程式についての成果を単独で発表しています*4。10月6日付の発表では、「社内のフロンティアモデル」という言葉に、この9月の発表へのリンクが張られています。
ナビエ–ストークス方程式は、水や空気のような流体の動きを表す方程式です。その「存在と滑らかさ」は、2000年にクレイ数学研究所が選んだ7つのミレニアム懸賞問題の1つで、1934年にLerayが一般化された意味での解の存在を示して以来、約90年にわたって未解決とされてきました。
OpenAIが9月8日の発表で主張している内容は、次のとおりです。
進め方についての説明は、次のとおりです。
| 項目 | OpenAIの説明 |
|---|---|
| 使ったモデル | GPT-6 Astraを大幅に上回る能力を持つ社内モデル。8月28日から訓練中で、発表時点でも訓練は続いている |
| 仕組み | 社内モデルを基盤にしたマルチエージェントシステム。答えにたどり着いたグループでは約1万のエージェントが同時に動いた |
| かかった時間 | 最初のエージェントを起動してから約88時間後、9月5日に到達 |
| 形式化と検証 | GPT-6 Astraを使って、さらに17時間 |
| オイラー方程式の反証 | 約100のエージェントで約50時間 |
9月のミレニアム懸賞問題の論文そのものは、今回の論文一覧には見当たりません。今回のリポジトリにもナビエ–ストークス方程式に関する成果は入っていますが、外力を加えた流れで万能計算(どんな計算手順でも実行できる仕組み)を組み立てる、という別の結果です。
ナビエ–ストークス方程式の件は、数学界での検証を経て確定した結果として扱うのではなく、現時点ではOpenAIの主張として受け止めておくのが妥当です。
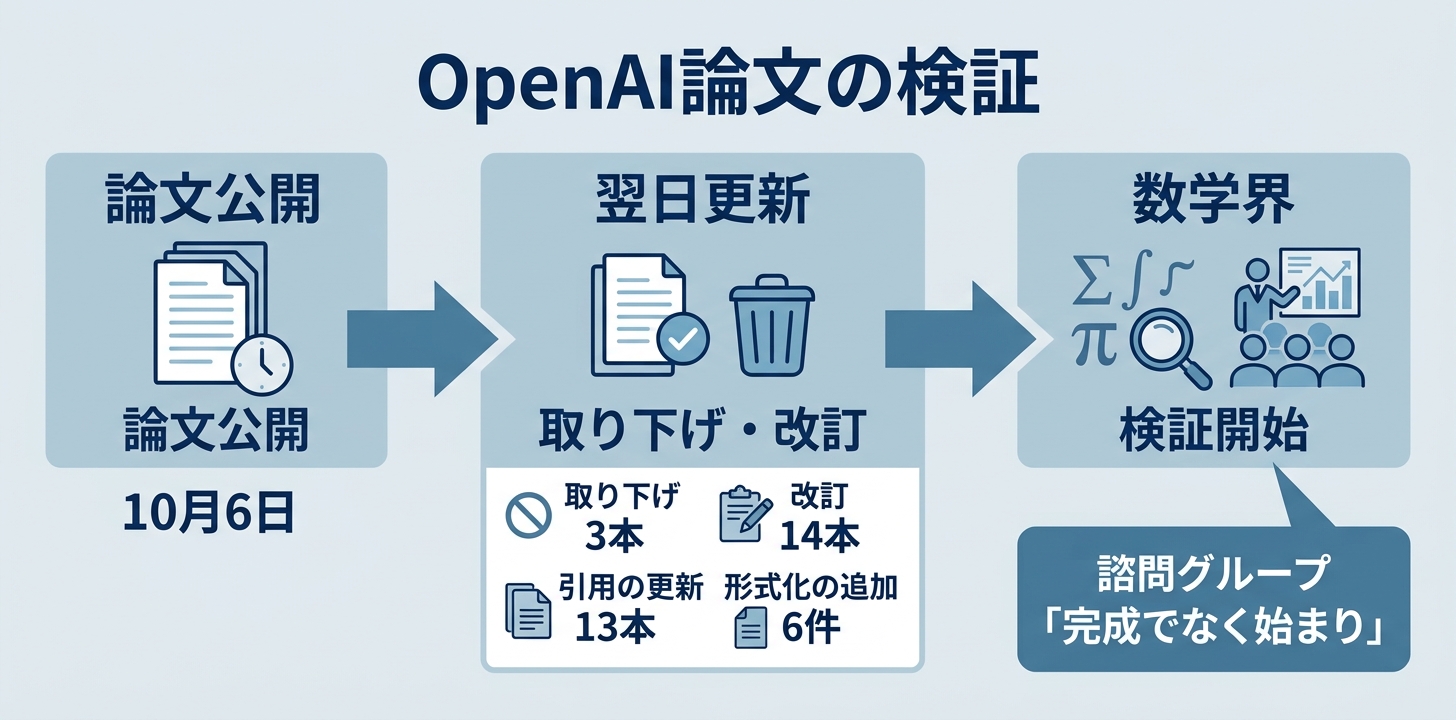
今回の論文は、公開した時点で正しさが確定しているわけではありません。そう言える理由は3つあります。
10月7日付の更新の中身は、次のとおりです。
| 更新の種類 | 本数 | 中身 |
|---|---|---|
| 取り下げ | 3本 | 「Algebraicity of Weil classes on split abelian eightfolds」の符号の誤りにより論証が成り立たなくなったため、この論文に依存する2本とあわせて取り下げ |
| 改訂 | 14本 | 証明の修復、主張の訂正、仮定や依存関係の明確化、古い引用の削除 |
| 引用の更新 | 13本 | 改訂された関連論文の新しい版を引用するように修正 |
| 形式化の追加 | 6件 | 主要な結果の形式化率が300 / 719(約42%)に |
取り下げた論文には、不備のあった箇所を説明する注記と、保管された元の原稿へのリンクが付いています。誤りを消して終わりにせず、経緯を含めて残す形をとっています。
リポジトリのREADMEには、すべての結果にLeanの形式化が付いているわけではなく、未形式化の結果の一部には問題がある可能性があると明記されています。問題が見つかり次第速やかに修正する方針も示されています。
主要な結果の形式化率は約42%なので、半数以上はまだコンピューターによる検証を経ていません。形式化は、できたものから順にリポジトリへ追加されていきます。
公開方法を助言した諮問グループは、OpenAIの公開を受けて声明を出しています*5。要点は次の4つです。
このグループは、次のような立ち位置の組織です。
| 項目 | 内容 |
|---|---|
| 正式名 | Advisory Group on Mathematics and Artificial Intelligence(AGMAI) |
| メンバー | 9名(下記) |
| 報酬 | この活動に対しては受け取らない |
| 独立性 | どのAI企業からも独立して運営され、AI企業に対する意思決定権は持たない |
| できた経緯 | OpenAIが外部諮問委員会の設立を打診したことをきっかけに、代わりに独立したグループとして発足 |
メンバーと所属は次のとおりです。
このグループは公開に先立つ9月29日に、AIが生み出した数学の責任ある公開についての提言を出しています*6。主な項目は次のとおりです。
OpenAIは、この提言を公開方法に取り入れたとしています。提言にどれだけ沿えているかの評価は、声明にあるとおり数学界に委ねられています。
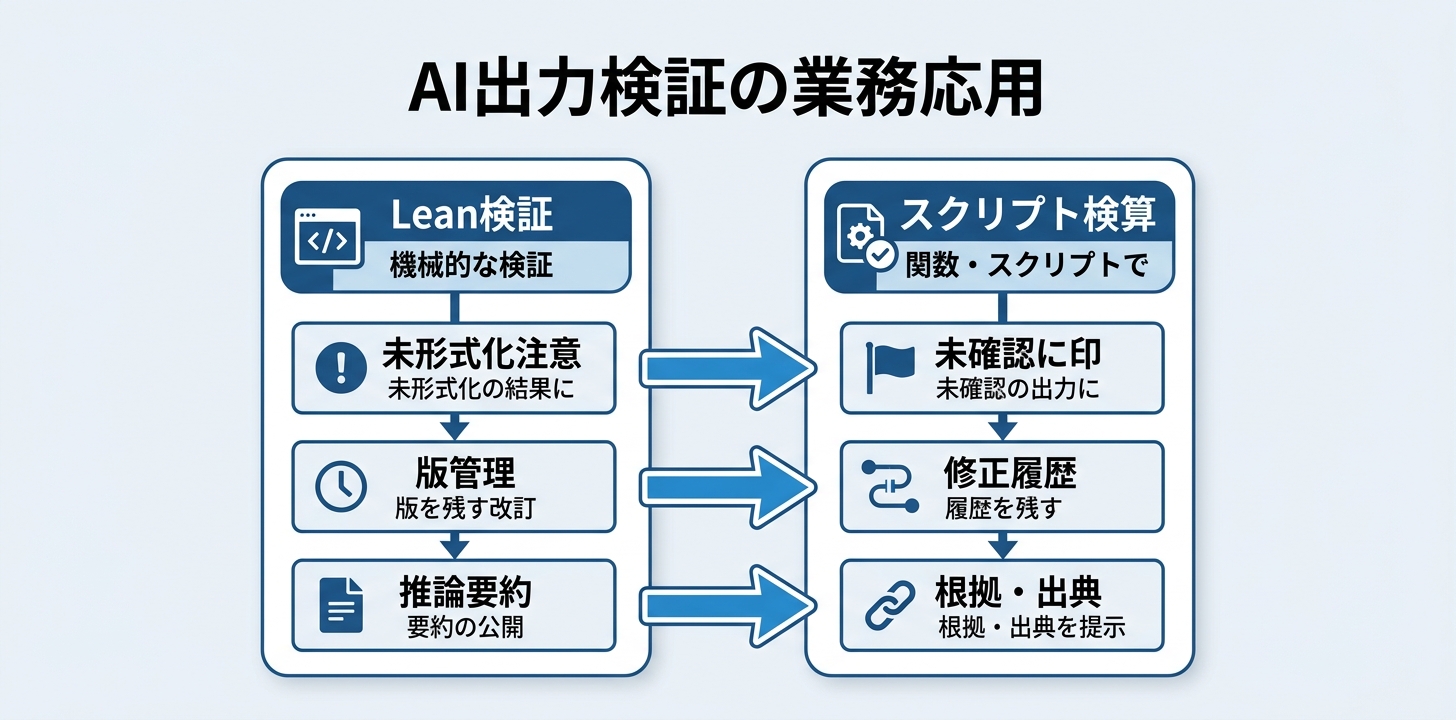
数学の中身が分からなくても、今回の公開から仕事に持ち帰れることは3つあります。
既存の数学の評価で性能が頭打ちになり、未解決の研究問題で実力を測る段階に入った。今回の公開の出発点はここにあります。「AI開発は減速している」という話は、なかったことになりつつあると私は見ています。
OpenAI自身も9月8日の発表で、AIの進歩における次の時代に入ったと考えている旨を述べています。同じ発表では、進歩のペースについて、より慎重な判断が必要になる場合もあるとしています。
OpenAIは、これらの成果を生み出したモデルを責任ある形で公開するための取り組みを進めているとしています。9月の発表でも、使った社内モデルを「GPT-6 Astraを大幅に上回る能力を持つ」と説明していました。
現行のOpenAIの最上位モデルはGPT-6 Astraですが、社内ではそれを上回るとされるモデルが、すでに研究レベルの数学に取り組んでいます。今回の公開は、その実力の一端を外から確かめられる材料になっています。
今回の公開でいちばん仕事に近いのは、AIの出力を「確かめられる形」で出している点です。業務でAIを使うときも、同じ考え方をそのまま使えます。
| 今回の公開でしていること | 業務に置き換えると |
|---|---|
| Leanで証明をコンピューターに検証させる | 計算や集計は、表計算の関数やスクリプトで検算する |
| 未形式化の結果に問題がありうることをREADMEで明記する | 人が確認していない出力には「未確認」と書いてから回す |
| 改訂を新しいバージョンとして記録し、過去の版も残す | 修正の履歴を残し、どこを直したか追えるようにする |
| 推論の要約や計算資源の推定値を公開する | AIに根拠や出典も一緒に出させ、後から確かめられるようにする |
| 取り下げた論文に、穴の説明を付けて残す | 誤りが見つかったら、何が違ったのかを共有する |
研究レベルの数学で成果を出すモデルであっても、公開翌日に符号の誤りで3本が取り下げられています。AIが速く大量に出力できるようになるほど、人が確かめる工程をどこに入れるかで、使いこなしの差がつきます。
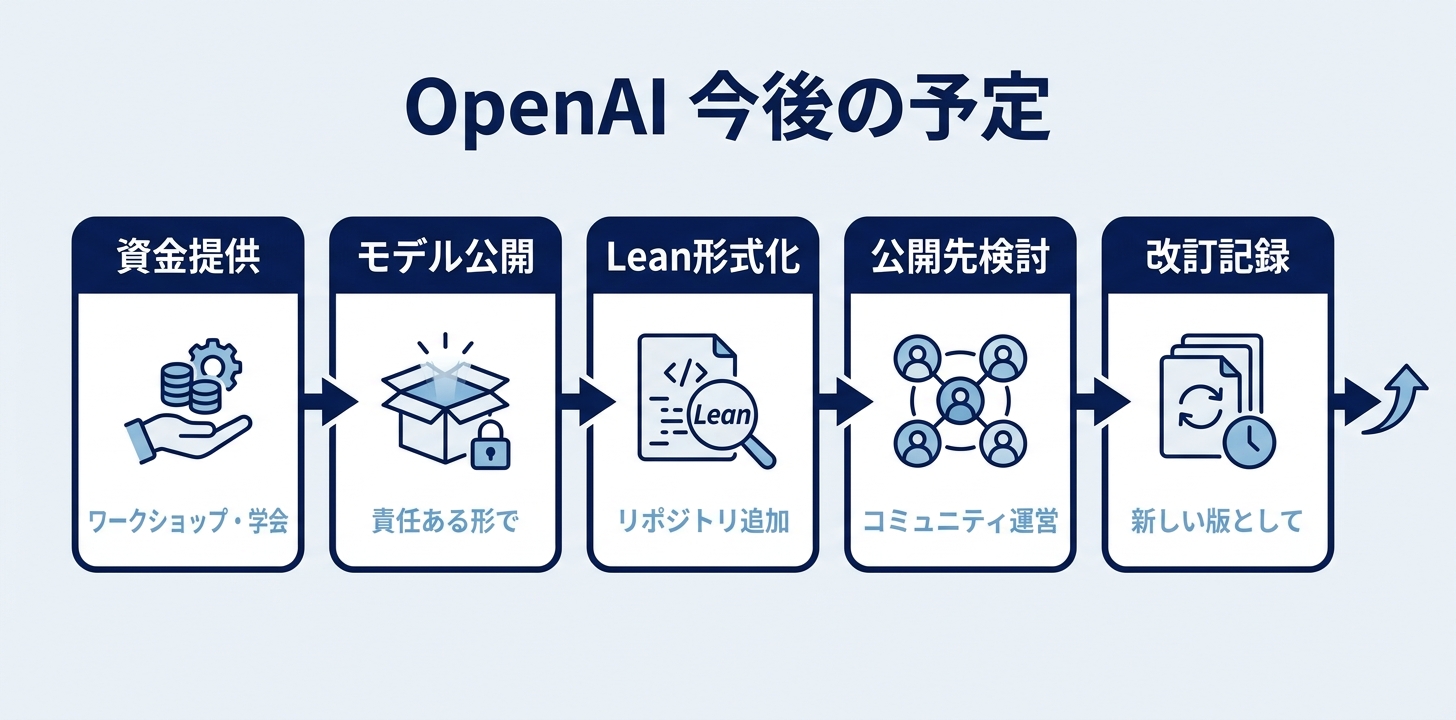
OpenAIが示している今後の動きは、次のとおりです。
| 予定 | 中身 |
|---|---|
| 理解を深める場への資金提供 | AIが生み出した主要な成果の理解を深めるため、一連のワークショップ・学会・特別プログラムに資金を出す。詳細は近く発表 |
| モデルの公開 | これらの成果を生み出したモデルを、責任ある形で公開するための取り組みを進めている |
| 形式化の追加 | Leanによる形式化ができ次第、リポジトリに追加する |
| 公開先の検討 | コミュニティが運営するほかの公開先も、引き続き検討する |
| 改訂の記録 | 訂正や改訂は新しいバージョンとして記録し、過去の版も読める状態を保つ |
資金提供は、諮問グループの提言にあった「人間による理解を資金面も含めて支える」という項目に沿った動きです。論文は今後も改訂されうるので、特定の結果を社内資料などで引用する際は、どのバージョンを参照したかを明記しておくと後からの確認がスムーズになります。
ここまで読んで「AIの出力を確かめる仕組みまで含めて、自社の業務に組み込みたい」と感じた方へ。法人向けAI研修の導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
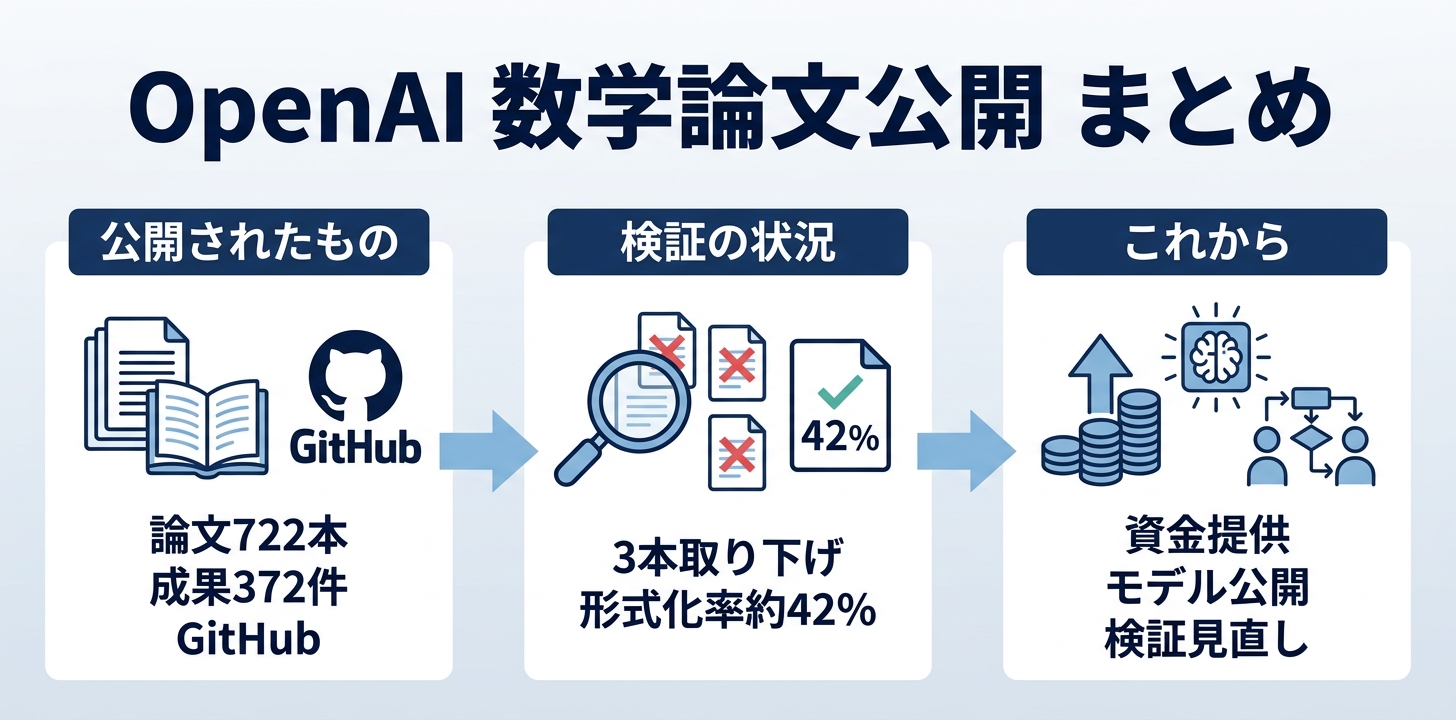
今回のポイントをまとめます。
AIが研究レベルの数学で成果を出し始めた一方で、その正しさを確かめる作業はこれからです。AIに任せた作業を、どこでどう確かめるか。今回の公開をきっかけに、あなたの職場でも一度見直してみてください。
現行のOpenAIの最上位モデルであるGPT-6 Astraについては、以下の記事で詳しく解説しています。
GPT-6 Astraとは?「賢い回答」からPC作業の代行へ。仕様・料金・使える範囲を一次ソースで整理
Astraに迫る性能をより安い料金で使えるGPT-6.1 Solについては、こちらの記事をご覧ください。
GPT-6.1 Solとは?GPT-6 Astraに迫る性能を5分の1のコストで使う方法
\AIを活用したノウハウが詰まった/ 資料ダウンロードはこちら