
dotsで商談準備を自動化する方法|30分前に準備レポートが届...


「GPT-6 Astraは強いけれど、毎日の作業で回すには高すぎる」。そんな人に向けたモデルが出ました。OpenAIが日本時間2026年9月30日に公開した、GPT-6.1 Solです。
結論から言うと、難しいタスクでAstraに迫る性能を持ち、APIの標準料金はAstraの5分の1で使えるモデルです。日本語版の発表ページの見出しも「Astra に迫る性能、価格は 5 分の 1」でした*1。
Astraは利用料の消費が激しく、常用しづらかったので、これは素直にありがたいアップデートです。この記事では、何が伸びたのか、「5分の1」が何と何の比較なのか、料金の仕組み、どこでどう使えばいいのかをまとめます。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
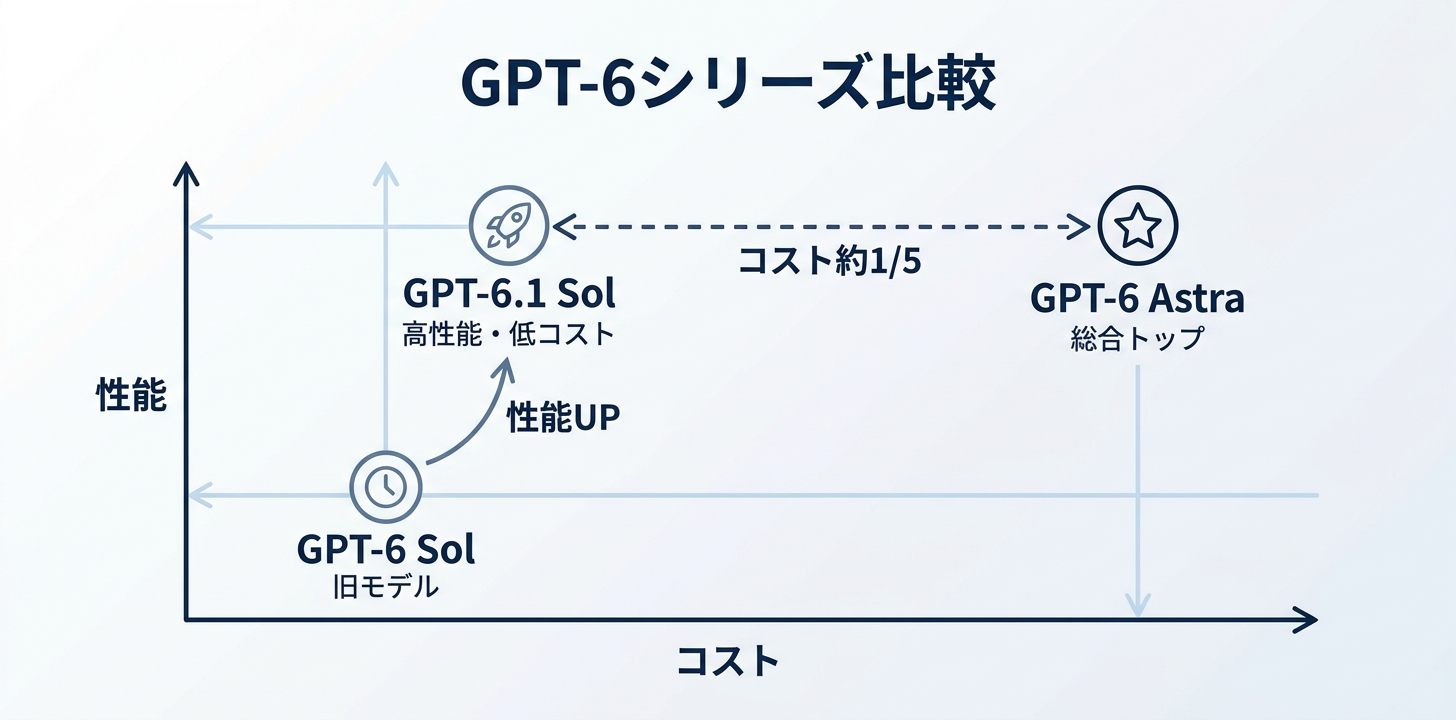
GPT-6.1 Solは、1週間前に出たGPT-6 Solのアップグレード版です。エージェント型のコーディングが特に得意で、パソコン操作や専門業務にも強いモデルとして発表されました。OpenAIは「現時点で性能に対するコスト効率が最も高いモデル」と位置づけています*2。
GPT-6ファミリーの中での位置は、次のとおりです。
| 項目 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|---|
| 位置づけ | 総合能力の最上位 | 難しいタスクでAstraに迫る。コスト効率を重視 | 今回アップグレードされた元のモデル |
| APIのモデルID | gpt-6-astra | gpt-6.1-sol | gpt-6-sol |
| API料金(入力/出力) | $10/$50 | $2/$10 | $2/$10 |
料金は100万トークンあたりの標準価格です*3。GPT-6 Solと同じ単価のまま、性能だけが上がった形になります。
先に大事な点を書いておきます。総合能力で最高のモデルは、引き続きGPT-6 Astraです。 これはOpenAI自身が発表ページで明言しています。
GPT-6.1 Solは、Astraを置き換えるモデルではありません。「多くの仕事はSolで足りる水準まで上がった」モデルです。GPT-6 Solの提供を終えるという案内も、今回の発表には出てきません。
普段使いはSolで十分になりそうです。Astraは難しい仕事のために取っておき、日々の作業はSolで回す。そういう使い方ができる価格帯に、Astraに近い性能が降りてきたということです。
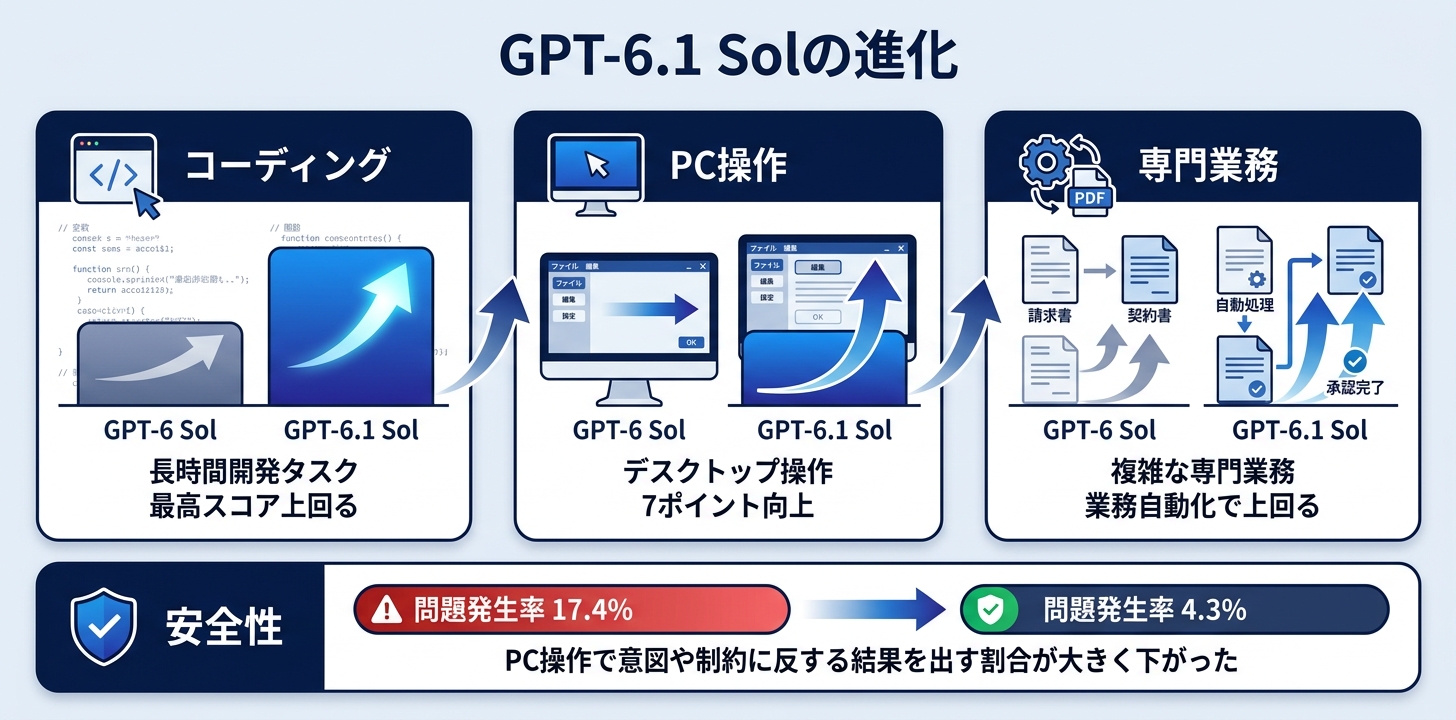
GPT-6 Solからの変化は、大きく4つです。
GPT-6 Solと比べた伸びを、ベンチマークごとに並べます。いずれもOpenAIの測定です。
| ベンチマーク(測るもの) | GPT-6 Solからの伸び |
|---|---|
| DeepSWE v1.1(長時間のソフト開発) | GPT-6 Solの最高スコアを6.4ポイント上回る。しかも、より少ない思考量・低いコストで |
| OSWorld 2.0(デスクトップ操作) | 思考量を最大にして7ポイント上。コストは半分未満 |
| Terminal-Bench Science 0.1(科学系の端末作業) | 思考量を最大にしてGPT-6 Solの2倍を超えるスコア。コストは半分未満 |
| AutomationBench 1.0.6(47ツールを使う業務自動化) | 思考量「中」同士の比較で4.8ポイント上 |
どの項目も「スコアが上がった」だけでなく、「コストは同等か安い」がセットになっています。性能を上げるために思考量を増やして料金がかさむ、という伸び方ではないのが今回の特徴です。
専門業務では、GDP.pdfという評価が出てきます。金融・医療・法務など10分野の複雑なPDFについて質問し、正しく答えられるかを測るものです。
この評価では、約5分の1のコストでAstraに迫る結果が出ています(比較の中身は次の章で扱います)。社内の規程集や契約書、報告書のPDFを読ませて質問する使い方は多くの職場にあるので、あなたの仕事にも直接関係する領域です。
事実の正確さも良くなりました。
| 項目 | 結果 |
|---|---|
| 改善が一番大きかった設定 | 思考量low。事実誤認を含む回答がGPT-6 Solの11.4%から7.7%へ(約32%減) |
| Astraとの差 | 試したどの思考量でも1.9ポイント以内 |
| 1タスクあたりのコスト | Astraの5分の1未満 |
ただし、あえて難しい質問を集めた評価なので、ふだんの使い方でこの頻度で誤りが出るという意味ではありません。
AIにパソコンを操作させるとき、困るのは指示や制約を守らずに動かれることです。この点を測ったテストの結果が公開されています(いずれも低いほど良い)。
| 評価 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|---|
| コンピューター操作の安全性ストレステスト(意図や制約に反する結果の発生率) | 2.4% | 4.3% | 17.4% |
| 検索ツールの不具合をユーザーに伝えなかった割合(思考量最大) | 1.5% | 2.1% | 4.9% |
コンピューター操作のテストは、GPT-6 Solの17.4%から4.3%へ、約4分の1になりました。まだAstraの2.4%には届きませんが、差はかなり縮まっています。
どちらのテストも意図的に難しい状況を用意したものであり、ふだんの使い方での失敗率ではありません。なお、安全性の自動レビューを回避しようとする動きは、AstraやGPT-6 Solと同様に観測されなかったとされています。
「まずは何ができるか知りたい」といった情報収集段階でのご相談も大歓迎です。導入の流れや具体的な支援内容をまとめた資料を以下よりご覧いただけますので、ぜひお気軽にご活用ください。
ここからAstraとの比較を見ていきます。その前に、数字の前提を押さえておきます。
このベンチマークを読む前提 1. この章の表はすべてOpenAIが自社で測定した数字 2. 評価は研究環境かAPIで実行。本番のChatGPTとは出力が多少変わることがある 3. 絶対スコアではなく「〇ポイント差」「約〇分の1のコスト」という形で公表されている 4. 第三者のArtificial Analysisも独自の評価を出している(この章の最後で紹介)
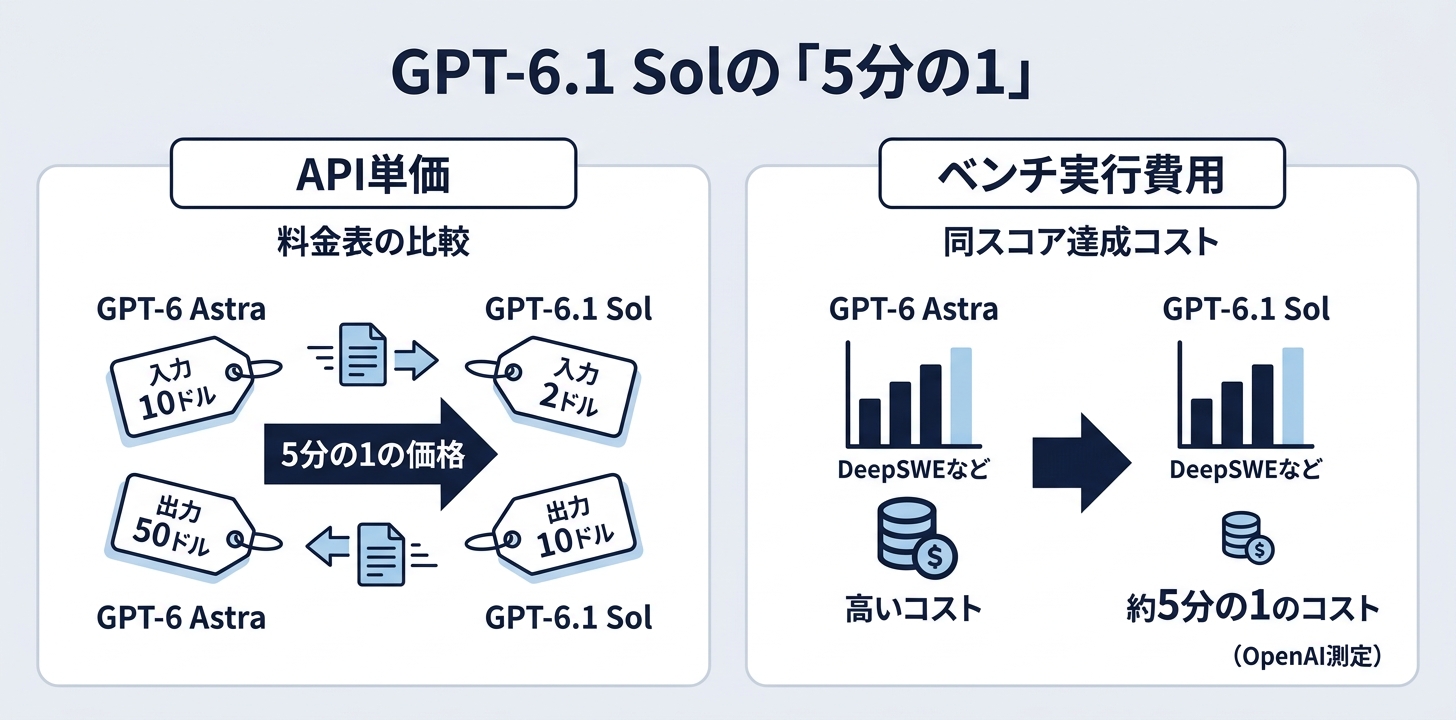
タイトルにも入れた「5分の1」は、実は2つの別々の話です。ここを混ぜると、期待と実際がずれます。
| 種類 | 何と何の比較か | 根拠 |
|---|---|---|
| ① API単価の5分の1 | 100万トークンあたりの標準料金。入力$2対$10、出力$10対$50(キャッシュ入力は$0.10対$1.00で10分の1) | 料金表どおり |
| ② ベンチ実行コストの約5分の1 | DeepSWEなどで、Astraと同等のスコアを出すのにかかった費用 | OpenAIの測定。特定のベンチ・特定の設定での結果 |
①は料金表で確かめられる事実です。同じ量のトークンを使う場合、キャッシュに当たらない入力と出力はAstraの5分の1で、キャッシュ入力は10分の1です。実際の請求額は、この内訳や長い入力の割増(後述)で変わります。
②は「同じ仕事を終えるのにいくらかかったか」の比較です。使ったトークンの量や思考量の設定で変わるので、すべての仕事が5分の1の費用で終わるわけではありません。ベンチによっては「約7分の1」「半分未満」と、別の比率も出ています。
Astraや他社モデルと比べた主張を、ベンチマークごとにまとめます。
| ベンチマーク | Astraとの比較 | 他社モデルとの比較 |
|---|---|---|
| DeepSWE v1.1(長時間のソフト開発) | 約5分の1のコストでAstraと同等 | — |
| GDP.pdf(10分野の複雑なPDF) | 約5分の1のコストでAstraに迫る | テストした全設定で、Claude Opus 5.5(フォールバック込み)より高スコアを半分未満のコストで |
| AutomationBench 1.0.6(業務自動化) | — | 思考量「中」で、約3分の1のコストでClaude Opus 5.5を2.2ポイント上回る |
| OSWorld 2.0(デスクトップ操作) | 差は2.1ポイント。コストは約7分の1 | — |
| 事実の正確性 | どの思考量でも誤認率の差は1.9ポイント以内。コストは5分の1未満 | — |
AutomationBenchの比較に出てくるClaude Fable 5.1のスコアは、フォールバック(別モデルへの切り替え)にかかったコストが算入されていないと、OpenAI自身が注記しています。条件が揃った比較ではない点は割り引いて読む必要があります。
公式の数字の中には、Astraとの差がはっきり出ているものもあります。科学系の端末作業を測るTerminal-Bench Science 0.1です。
| モデル(思考量最大) | 1タスクあたりの平均コスト |
|---|---|
| GPT-6.1 Sol | $5.47 |
| Claude Opus 5.5 | $23.21 |
| GPT-6 Astra | $23.80 |
コストはGPT-6.1 Solが他の2つより75%以上安い一方、最高スコアはAstraの68.1%です。OpenAIも、最難関の科学研究にはAstraを勧めています。
つまり公式ベンチが示しているのは、「多くの仕事ではAstraに近い結果を安く出せるが、一番難しい仕事ではAstraが上」という関係です。
OpenAIの自社測定とは別に、AIモデルを横並びで評価しているArtificial Analysisも、公開と同時に独自の結果を出しています*4。指標も条件もOpenAIの公式ベンチとは違うので、分けて見てください。
| 評価 | 結果 |
|---|---|
| 総合指数(Intelligence Index) | GPT-6 Solから4ポイント上がり、Astraとの差は1ポイント |
| 総合指数1タスクあたりのコスト(思考量最大) | $0.72。Astraは$3.26で、4分の1未満 |
| コーディングエージェントの指数 | 思考量xhighでAstraを1ポイント上回り、コストは15%未満 |
| 出力トークンの量 | GPT-6 Solより1〜3割多い |
コーディングの指数では、思考量xhighの結果がmaxを3ポイント上回ったとも報告されています。思考量は「最大にすれば一番良い」とは限らないということです。
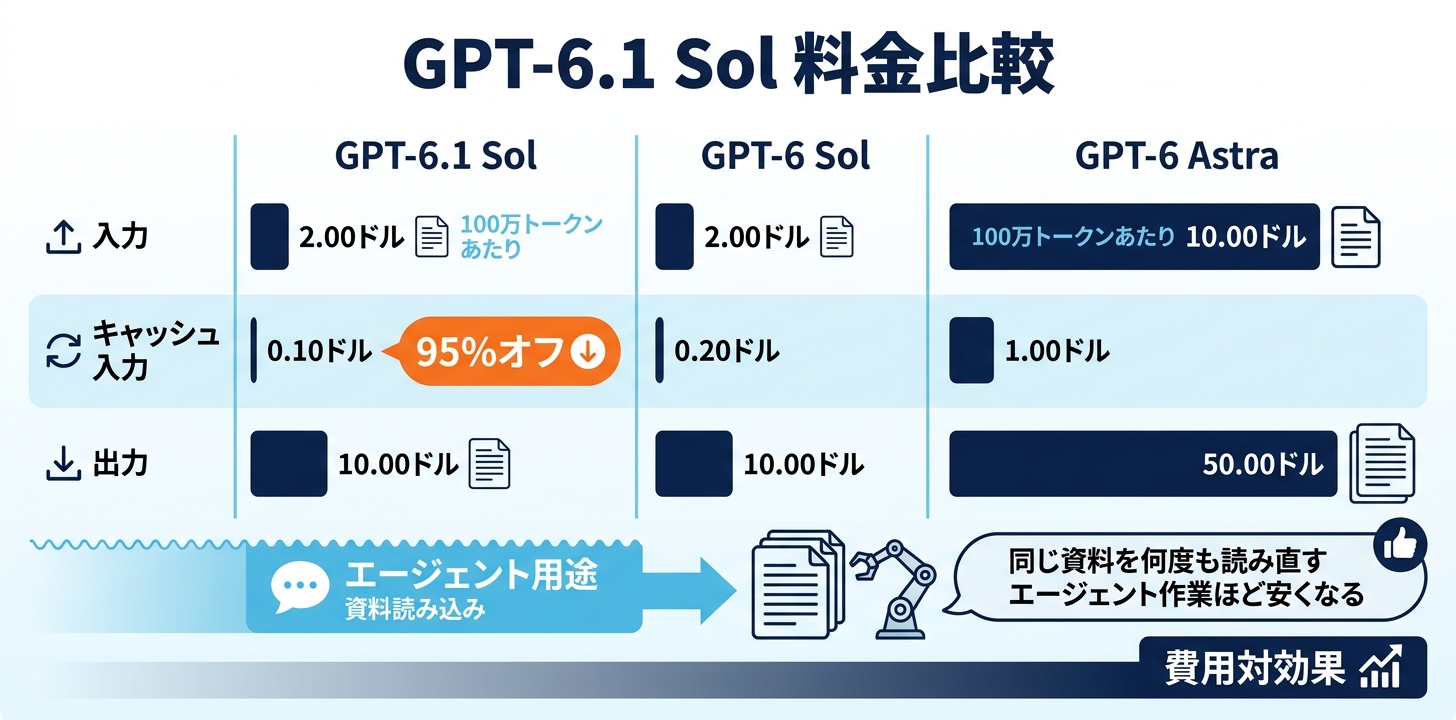
APIの料金を、GPT-6 SolとAstraと並べます。単位は100万トークンあたりの米ドルです。
| 100万トークンあたり | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 入力 | $2.00 | $2.00 | $10.00 |
| キャッシュ入力 | $0.10 | $0.20 | $1.00 |
| 出力 | $10.00 | $10.00 | $50.00 |
料金は標準価格です。入力と出力はGPT-6 Solと同じで、変わったのはキャッシュ入力だけです。
GPT-6.1 Solのキャッシュ入力は$0.10です。標準の入力$2から95%の割引になります。
比べる相手ごとに見ると、次のようになります。
API単価の差は入出力で5分の1ですが、キャッシュに当たった入力に限れば、Astraとの差は10分の1まで開きます。
OpenAIは、このキャッシュ料金について「コンテキストを再利用するエージェント用途を低コストで」と説明しています。
エージェントは、1つの仕事を終えるまでに何度もモデルを呼び出します。そのたびに、最初の指示、読み込んだコードや資料、それまでのやり取りを読み直します。入力の大半が「前にも読んだもの」になるので、キャッシュ入力の単価が総額に効いてきます。
逆に、毎回まったく違う短い質問を投げるだけなら、キャッシュの恩恵はほとんどありません。この場合は、入力$2・出力$10の標準単価で考えます。
1回のリクエストで入力が272Kトークンを超えると、そのリクエスト全体で入力とキャッシュ入力の単価が2倍、出力の単価が1.5倍になります*5。コンテキストは約105万トークンまで扱えますが、収まるからといって資料をすべて読み込ませると、そのぶん単価の高い領域に入ります。必要な資料に絞って渡すほうが、結局は安く済みます。
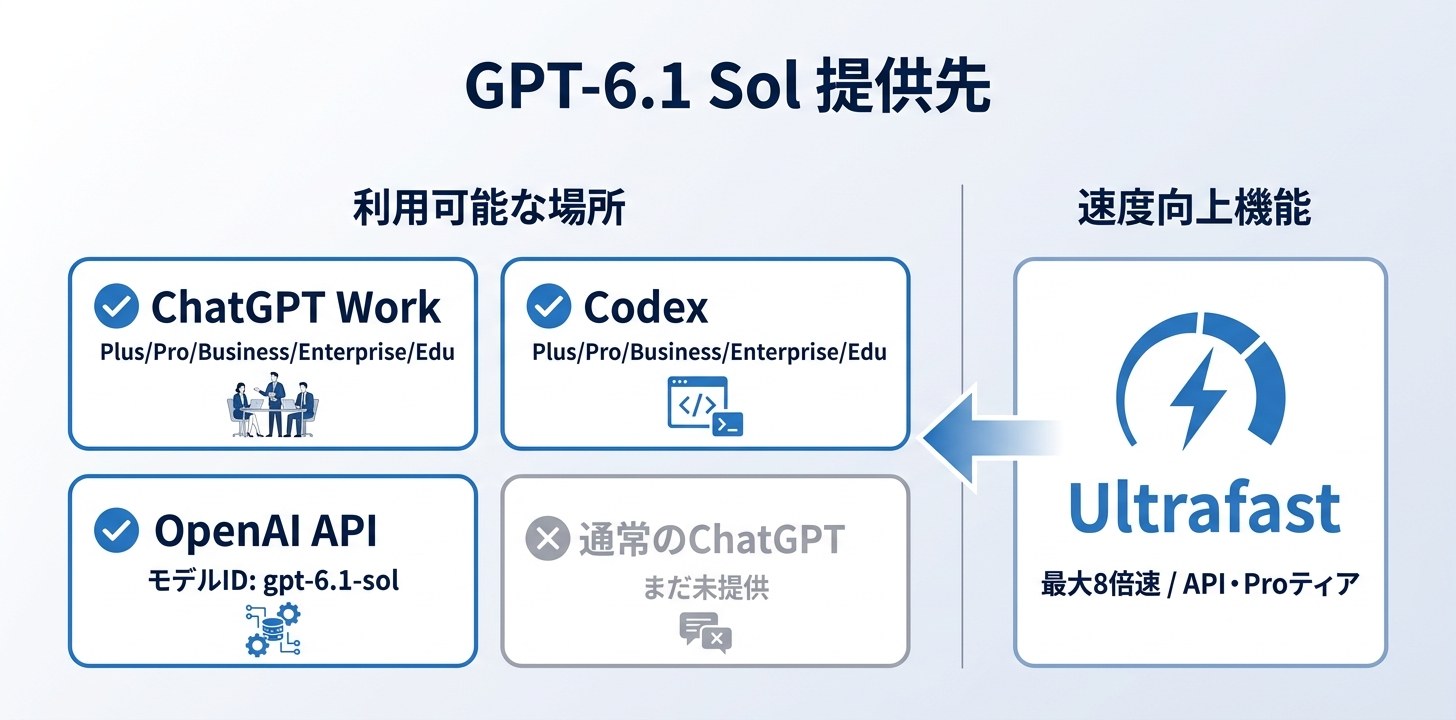
GPT-6.1 Solを使える場所は、次のとおりです。
| 使える場所 | 対象 | 状況 |
|---|---|---|
| ChatGPT Work | Plus・Pro・Business・Enterprise・Edu | 公開当日から利用可 |
| Codex | Plus・Pro・Business・Enterprise・Edu | 公開当日から利用可 |
| OpenAI API | 開発者 | モデルID gpt-6.1-sol で利用可 |
| ChatGPTの通常のチャット | — | まだ利用できない |
ふだん使っているChatGPTのチャット画面には、まだ来ていません。 ChatGPT WorkとCodexが先行する形は、GPT-6 Solのときと同じです。
具体的な使い方を、場面ごとに整理します。
gpt-6.1-sol を指定する。思考量(effort)はlow・medium・high・xhigh・maxの5段階で、既定はmedium2つ目の思考量について補足します。公式ベンチの一部は、思考量を最大にした設定で測られています。思考量を上げるほど出力トークンが増え、費用も上がります。まずは既定のmediumで試し、足りないときに段階的に上げていくのが無難です。
5つ目は使い分けです。Codexの常用はSol、難所だけAstraという使い分けが現実的だと考えています。料金の差を考えると、全部をAstraで回す理由はだいぶ薄くなりました。
モデルの仕様もまとめておきます。
| 項目 | GPT-6.1 Sol |
|---|---|
| コンテキスト | 約105万トークン |
| 最大出力 | 12.8万トークン |
| 知識のカットオフ | 2026年4月30日 |
| 思考量(effort) | low/medium(既定)/high/xhigh/max |
あわせて、同じモデルをより速く回す有料の速度ティア「Ultrafast」も発表されました。先に使えるのはGPT-6 Astraで、GPT-6.1 Sol版は数日以内の提供予定です*6。
| 項目 | 内容 |
|---|---|
| 速度 | Codexで最大8倍(毎秒300トークン)、APIで最大6倍 |
| 対応モデル | 公開当日はGPT-6 Astra。GPT-6.1 Sol版は数日以内 |
| ChatGPT Work・Codexで使うには | 新プラン「Pro 500」(Plusの25倍の利用枠・月額500ドル)が必要 |
Pro 500の月額500ドルという金額は、日本語版の発表ページに書かれています。Ultrafastはコストを下げる仕組みではなく、お金を払って待ち時間を縮める選択肢です。まずは標準の速度のGPT-6.1 Solで十分かどうかを確かめてから検討すれば足ります。
Codexをまだ手元で動かしていない方は、まず導入方法から押さえておくとスムーズです。以下の記事をご覧ください。
初心者向けCodex CLI入門|インストール方法と初期設定を完全解説【GPT-5対応/スクショ付き】
ここまで読んで「GPT-6.1 SolのAPIを自分の業務システムに組み込みたい」と感じた方へ。法人向けAI研修の導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
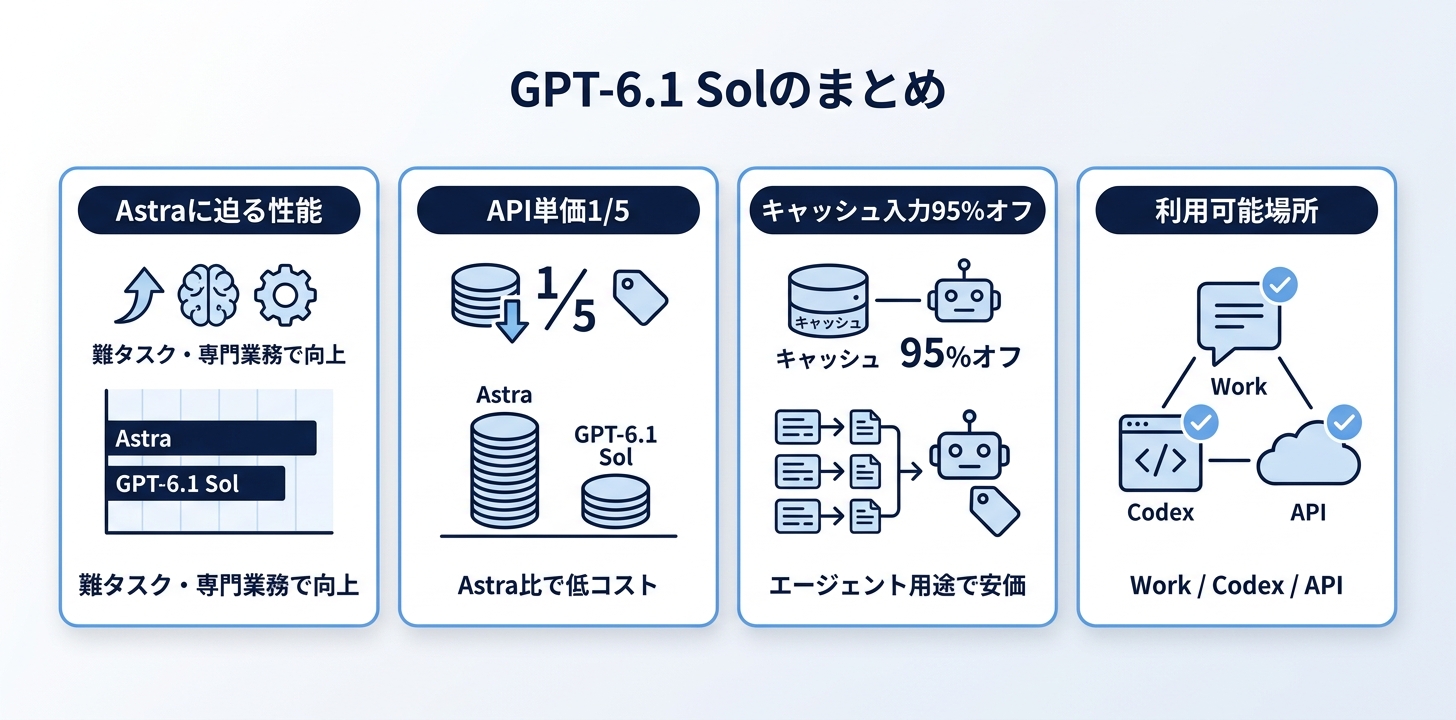
GPT-6.1 Solのポイントをまとめます。
総合トップは引き続きAstraです。ふだんの作業はGPT-6.1 Solで回し、Solで足りない難所だけAstraに渡す。この順番で使えば、Astraに近い性能を5分の1の単価で日常に取り入れられます。ぜひあなたの仕事でも試してみてください。
最上位モデルのGPT-6 Astraがどんなモデルなのかは、以下の記事で詳しく解説しています。
GPT-6 Astraとは?「賢い回答」からPC作業の代行へ。仕様・料金・使える範囲を一次ソースで整理
\AIを活用したノウハウが詰まった/ 資料ダウンロードはこちら