
Call Companionとは?Sierraの電話AIに画面...


Alibabaが次世代フラッグシップモデル「Qwen4-Max」を2026年11月16日に正式公開しました*1。料金は100万トークンあたり入力$1.50・出力$4.50で*2、AnthropicのClaude Opus 5.5(入力$4・出力$20)と比べると出力単価は4分の1以下です*3。
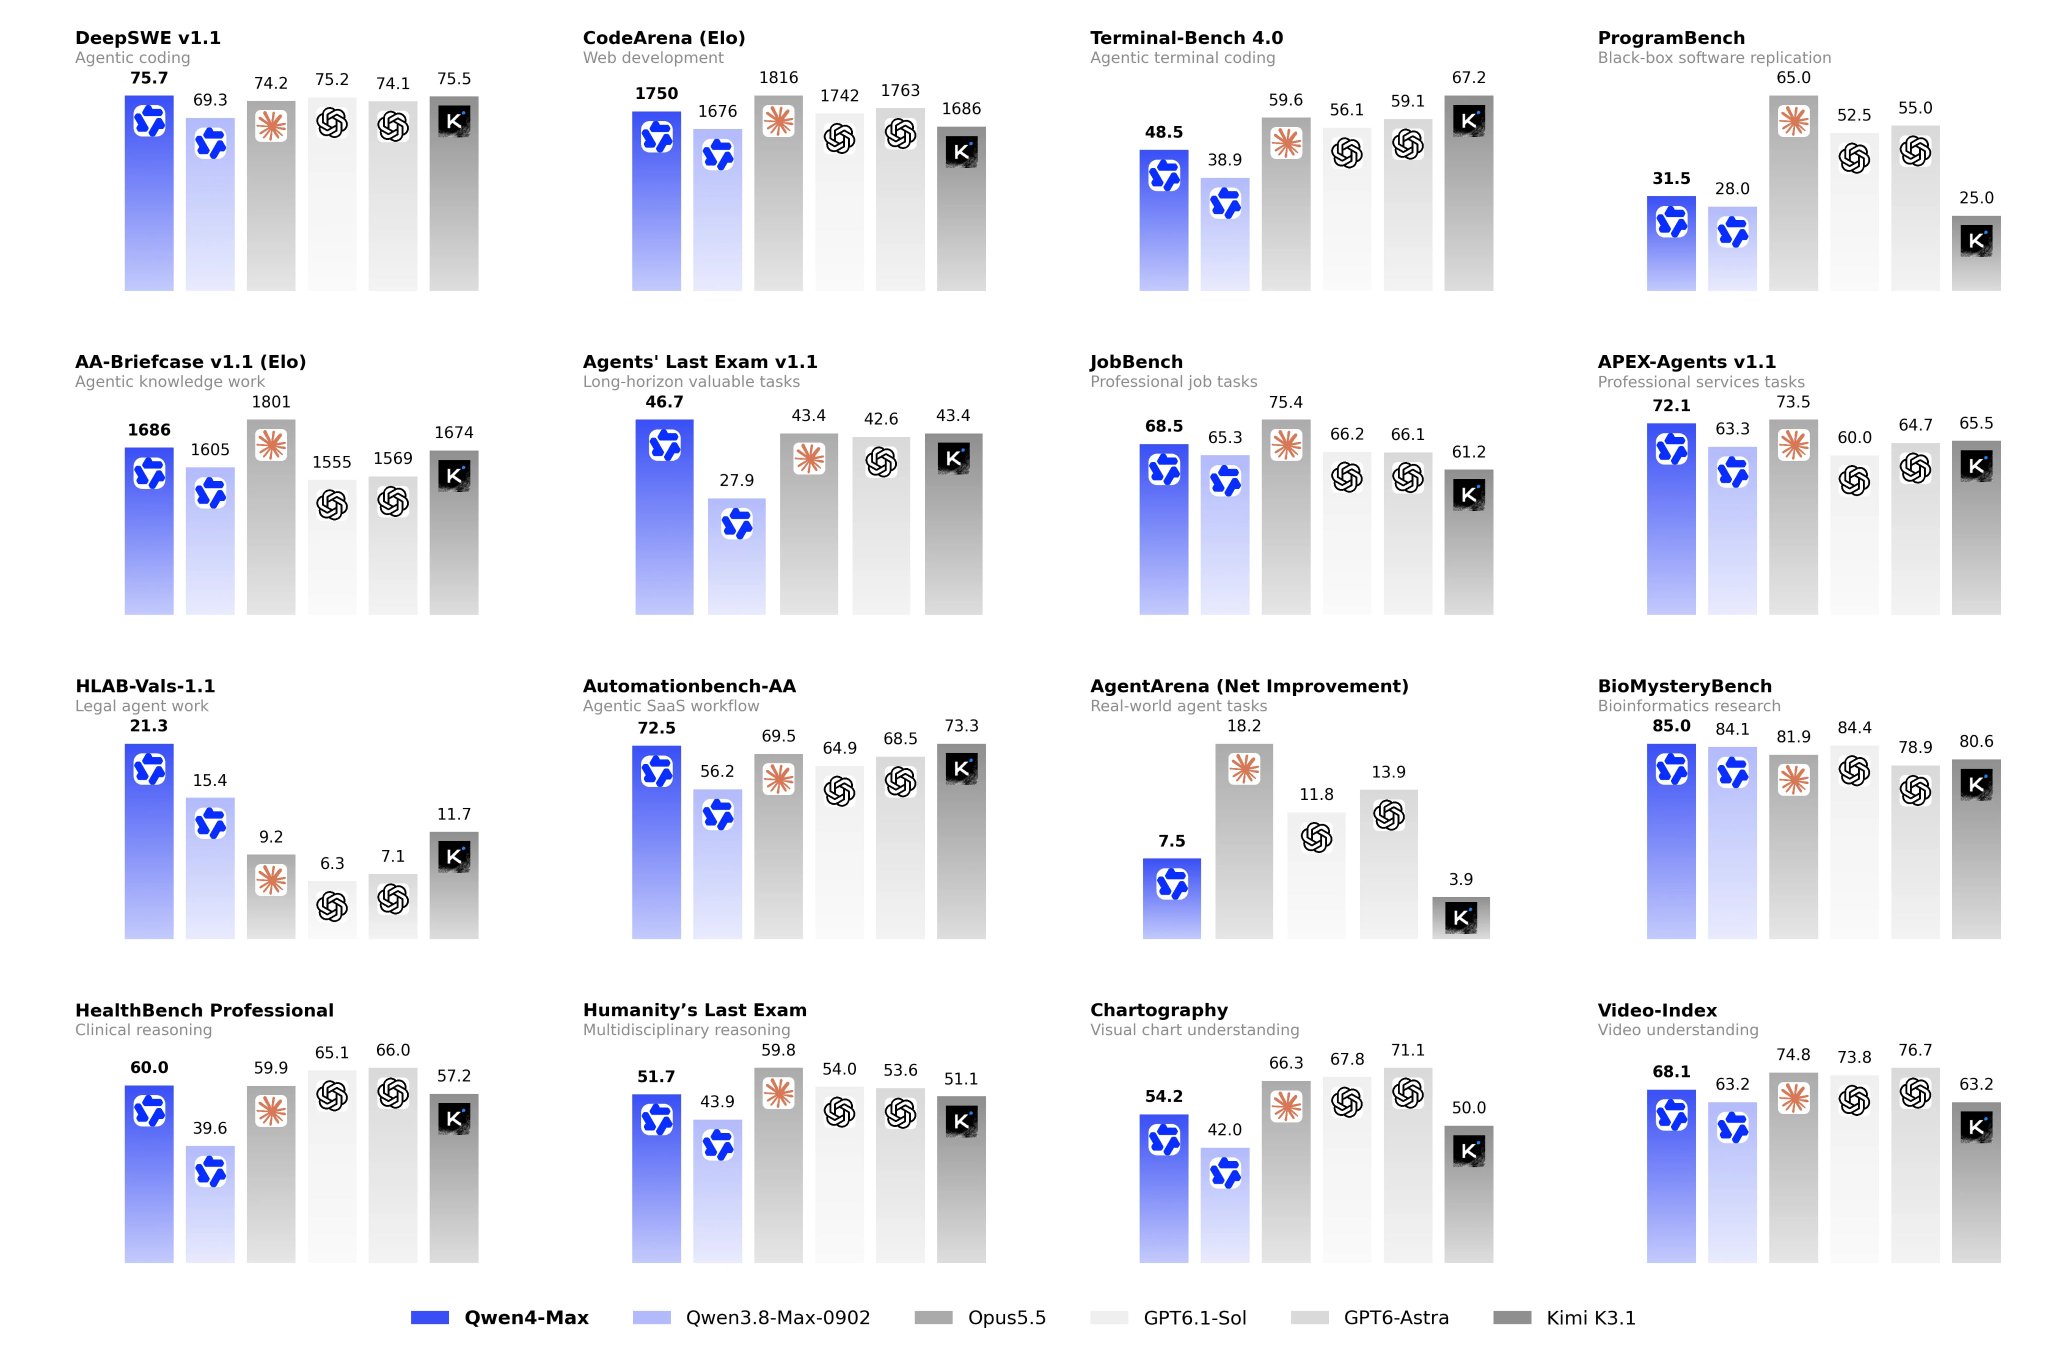
Alibabaが公開した比較表では、エージェント型コーディング評価のDeepSWE v1.1で75.7を記録し、Opus 5.5の74.2を上回りました*1。先に結論を言うと、難しい開発や高度な推論は引き続きOpus 5.5が有利ですが、定型の多い業務エージェントならQwen4-Maxはコスト面でかなり有力な選択肢です。ただし処理場所の設定など、企業が導入前に確認すべき点もあります。
この話題は、私もXで紹介しました。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
Qwen4-Maxは、AlibabaのQwenチームが開発したQwen4ファミリーの最初のモデルです。推論、画像・動画の理解、長時間のエージェント作業を1つのモデルでこなす設計になっています*4。
正式公開の前に、11月11日から11月25日まで「qwen4-max-preview」というプレビュー版がサブスクリプション型のToken Plan限定で提供されていました*5。11月16日の正式版から、使った分だけ払う従量課金のAPIでも呼び出せるようになっています*1。
| 項目 | 内容 |
|---|---|
| モデルID | qwen4-max |
| コンテキスト長 | 100万トークン |
| 最大出力 | 思考なし131,072トークン/思考ありは思考と回答で合計262,144トークン |
| 入力の種類 | テキスト・画像・動画 |
| 推論の深さ | low・high・xhigh の3段階(初期値はhigh) |
| APIの互換性 | OpenAI互換(Chat Completions・Responses)、Anthropic Messages、DashScope |
| 主な機能 | 関数呼び出し、構造化出力、Web検索、MCP、コード実行、明示的キャッシュなど |
| 非対応 | バッチ推論、ファインチューニング |
表の内容はQwen Cloudの開発者ドキュメントにもとづきます*4。注目したいのはAnthropic Messages形式の互換性です。Claude向けに作ったアプリやツールの接続先を差し替えるだけで試せるため、比較検証の手間が小さく済みます。
DataCampによると、QwenCloudのモデルページでは最大出力が393Kトークンと表示されており、ファインチューニングもQwenCloud上で対応しているとされています*1。一方、開発者ドキュメントでは上の表の通りになっています。契約前に最新のドキュメントで上限を確かめてください。
比較相手のOpus 5.5も整理しておきます。Claude Opus 5.5は2026年9月22日に公開されたAnthropicのモデルで、何時間も自律的に動くコーディングエージェントや大規模なリファクタリング、コンピューター操作など長時間の作業向けと位置づけられています*3。
| 項目 | Claude Opus 5.5 | Qwen4-Max |
|---|---|---|
| 公開日 | 2026年9月22日 | 2026年11月16日(正式版) |
| 入力単価(100万トークン) | $4 | $1.50(シンガポール) |
| 出力単価(100万トークン) | $20 | $4.50(シンガポール) |
| キャッシュ読み込み | $0.20 | $0.075 |
| コンテキスト長 | 100万トークン | 100万トークン |
| 最大出力 | 128Kトークン | 思考込みで262,144トークン |
| 入力の種類 | テキスト・画像 | テキスト・画像・動画 |
| 提供先 | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundryなど | Qwen Cloud(従量課金・Token Plan) |
Opus 5.5はバッチAPIで入出力とも50%引きになり、主要クラウド経由でも使えます*3。既存のクラウド契約の中で調達できる点は、情報システム部門にとって大きな違いです。
Opus 5.5と上位モデルFable 5.2の実際の使い心地の差は、以下の記事で解説しています。
Claude Codeとは?Opus 5.5とFable 5.2を実測比較|料金・使い方・活用事例
Alibabaが公開した比較表から、話題になった5つの評価を抜き出しました*1。数字はすべてAlibabaがまとめたもので、第三者が同じ条件で測り直したものではない点に注意してください。
| 評価 | 内容 | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | エージェント型コーディング | 75.7 | 74.2 | 75.2 |
| HLAB-Vals-1.1 | 法務のエージェント作業 | 21.3 | 9.2 | 6.3 |
| Agents’ Last Exam v1.1 | エージェントの総合課題 | 46.7 | 43.4 | 42.6 |
| Humanity’s Last Exam | 高難度の知識・推論 | 51.7 | 59.8 | 54.0 |
| Terminal-Bench 4.0 | ターミナル操作 | 48.5 | 59.6 | 56.1 |
法務評価のHLAB-Vals-1.1ではOpus 5.5の2倍を超えるスコアです*1。一方で高難度の推論を測るHLEでは8ポイント以上の差でOpus 5.5が上回っています。得意・不得意がはっきり分かれた結果と言えます。
Terminal-Bench 4.0については、比較表のOpus 5.5の数値と他の場で公表されている数値に差があると指摘されています*1。評価の実行環境で結果が変わるため、ベンチマークは目安にとどめ、自社の業務データで試すのが確実です。
ベンチマークの読み方そのものは、以下の記事で解説しています。
ベンチマークとは?Claude Fable 5.2のロボット性能64.9%|Opus 5.5と比較
複数のモデルを業務ごとに切り替える仕組みを自社で作りたい方へ。法人向けAIリスキリングサービスの導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
Qwen4-Maxの料金は地域で少し変わります。シンガポール(国際)は入力$1.50・出力$4.50、北京とGlobal(東京を含む)は入力$1.413・出力$4.24です*2。思考モードでも単価は同じで、入力の長さで単価が上がる段階料金もありません*2。
| 項目(100万トークンあたり) | Qwen4-Max(シンガポール) | Claude Opus 5.5 | Qwenの割合 |
|---|---|---|---|
| 入力 | $1.50 | $4 | 37.5% |
| 出力 | $4.50 | $20 | 22.5% |
| キャッシュ書き込み(5分) | $1.875 | $5 | 37.5% |
| キャッシュ書き込み(1時間) | $3.00 | $8 | 37.5% |
| キャッシュ読み込み | $0.075 | $0.20 | 37.5% |
たとえば1回のタスクで入力10万トークン・出力1万トークンを使う場合、単価だけで計算するとQwen4-Maxは約$0.20、Opus 5.5は$0.60です。月に1万回動かす業務エージェントなら、差は月$4,000ほどになります。
私の感覚では、出力が多いエージェント業務ほどQwen4-Maxの割安さが効いてきます。逆に入力が大半を占める要約や検索のような使い方では差は約2.7倍にとどまるので、乗り換えの効果は業務の形で変わります。
Qwen4-MaxをAPIで使う方法は2通りあります。用途によって向き不向きがはっきりしているので、先に違いを押さえておきましょう。
| 方法 | 向いている用途 | 注意点 |
|---|---|---|
| 従量課金API | 自社システムへの組み込み、業務エージェントの本番運用 | 使った分だけ課金。地域ごとに単価とデータの処理場所が変わる |
| Token Plan | 開発者が手元のコーディングツールで使う | Creditsを消費する方式。専用のAPIキーと接続先が必要で、従量課金のキーとは共通化できない |
従量課金APIで試すときの流れは次の通りです。
qwen4-max を差し替えます*4業務エージェントの組み立て方や汎用型・特化型の違いは、以下の記事で解説しています。
【驚異の業務革命】AIエージェントが実現する完全自動化の新時代 ―― OperatorとManusが変える業務の常識:汎用型&特化型エージェントの活用事例と導入ガイド
企業がいちばん注意すべきなのは推論の処理場所です。Qwen Cloudでは東京リージョンでも「Global」を選ぶと中国本土を含む任意のノードで推論が実行される可能性があります*6。データ保管は選んだリージョンですが、推論の場所は処理範囲の設定で決まります。
東京リージョンには日本国内だけで推論する「Japan」の処理範囲もありますが、Qwen4-Maxがそれに対応しているかは公式ドキュメントで確認できませんでした。個人情報や機密を扱う業務では、契約前に対応範囲を問い合わせるべきです。
qwen4-max で作ります中国発のモデルを業務でどう扱うかという観点では、TencentのオープンモデルとOpus 5.5の比較も参考になります。以下の記事で解説しています。
Tencentとは?オープンモデルHy4がPC操作に対応|料金・Claude Opus 5.5との比較
私のおすすめは、Opus 5.5をすぐに置き換えるのではなく、回数の多い業務エージェントから1つ選んでQwen4-Maxと並べて試すことです。出力品質と請求額を同じデータで比べれば、どこまで任せられるかが数字で見えてきます。難しい開発と高度な判断はOpus 5.5、定型の多い業務はQwen4-Maxという使い分けが、当面の現実的な落としどころだと私は考えています。
\AIを活用したノウハウが詰まった/
資料ダウンロードはこちら記事の検索結果をご案内します。詳しいご相談は担当者がお答えします