
Claudeとは?日本の利用は世界32位|企業導入の壁と活用事...


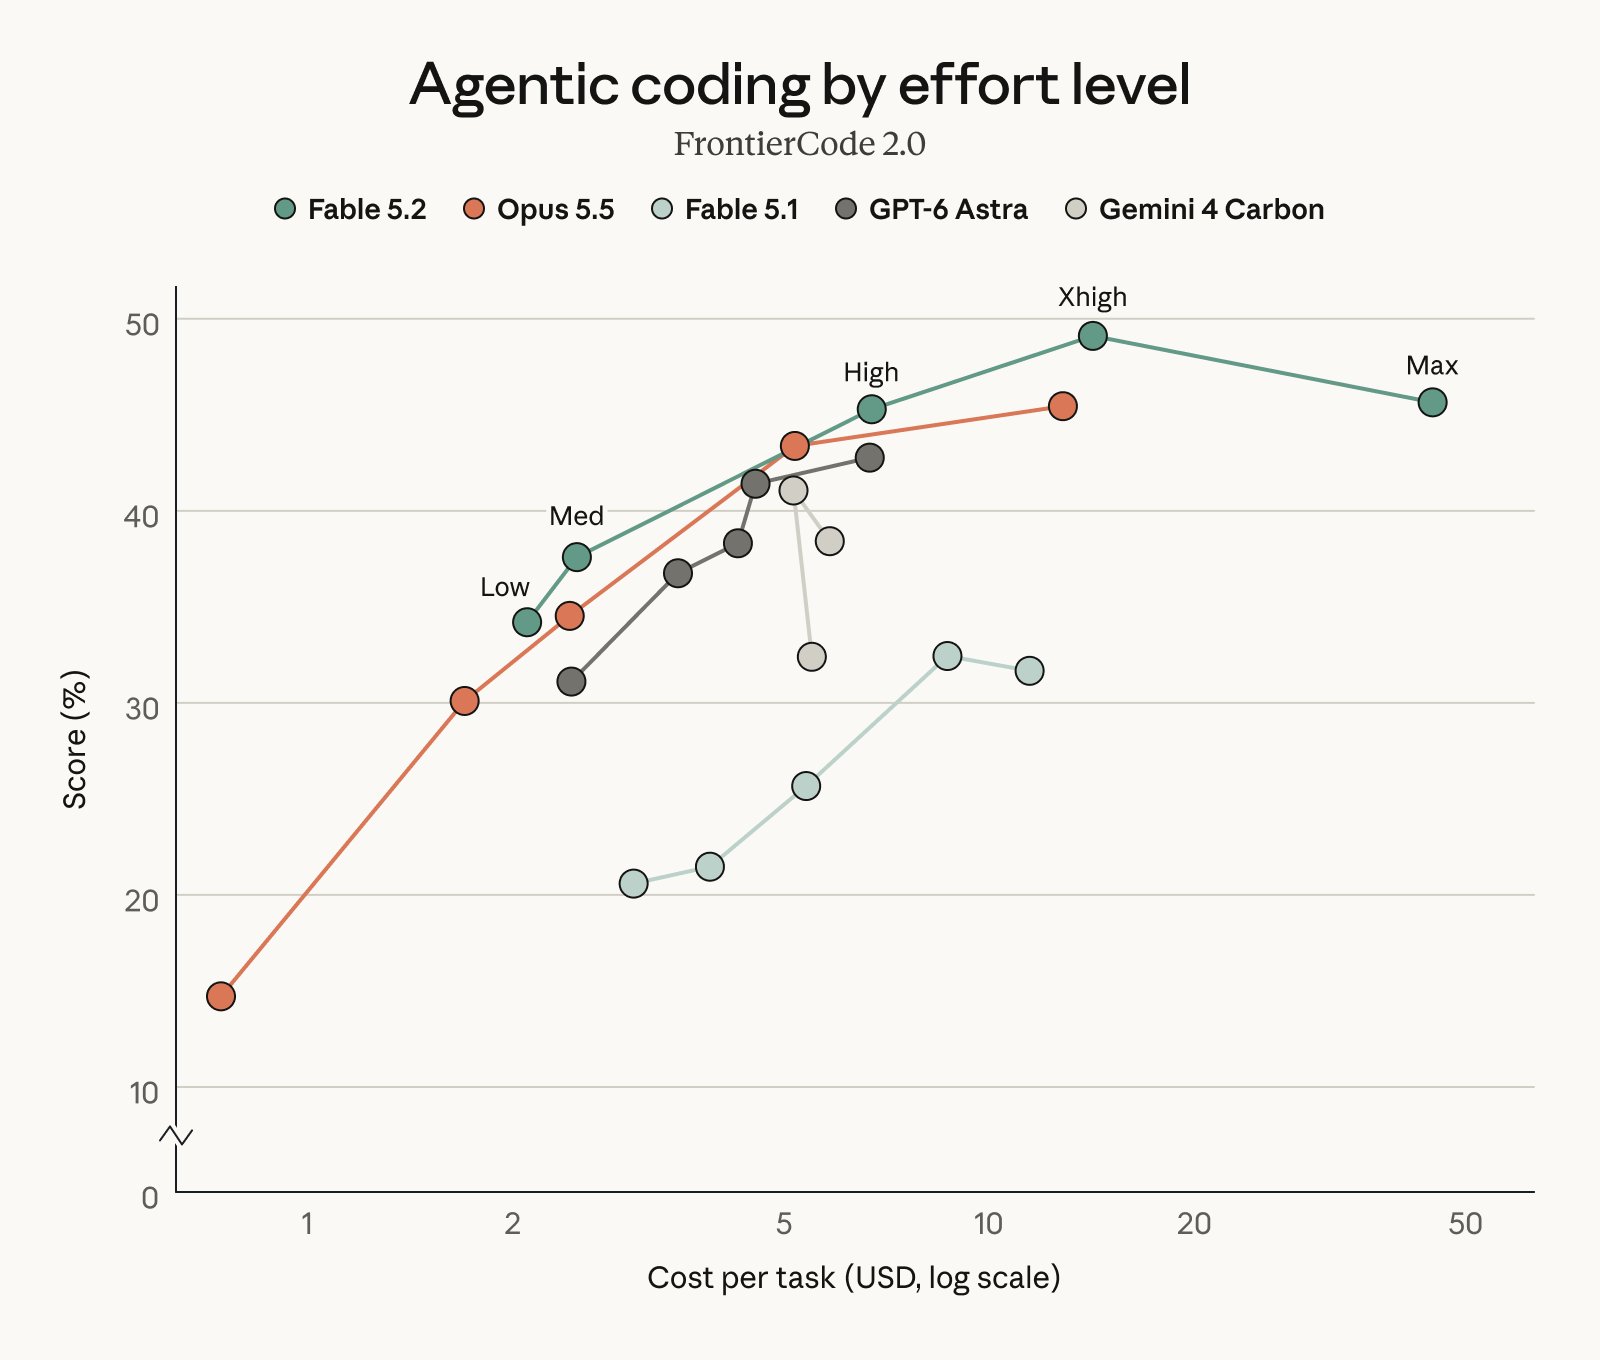
2026年11月9日、AnthropicがClaude Fable 5.2とClaude Mythos 5.2を発表しました*1。Fable 5.2はその日から一般提供されています。発表で私が一番面白いと思ったのは、ベンチマークの最高点よりもeffort(推論の深さ)ごとのスコアとコストのグラフでした。コーディングのベンチマークFrontierCode 2.0では、High設定のFable 5.2が45.3%で、Opus 5.5の最高effortでのスコア45.5%にほぼ並び、1タスクあたりのコストは約半分だと公表されています*1。
最高点はXhigh設定の49.1%で、公表時点で試されたリリース済みモデルの中で一番高いスコアです*1。一方でMaxについて、公式ドキュメントは「Xhighより遅くて高くつき、伸びは小さいことが多い」と書いています*2。先に結論を言うと、「とりあえずMax」はもう正解ではありません。既定の設定で始めて、詰まった仕事だけ1段ずつ上げるのが、性能と費用の両方で一番無駄のない使い方です。
この話題は、私もXで紹介しました。
今なら、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中!何から始めればいいか分からない方でも、これ1冊で導入の流れがつかめます。
目次
effortは、Claudeが1回の回答でどれだけトークンを使うかを決める設定です。Anthropicの公式ドキュメントでは「回答の丁寧さとトークンの節約のどちらを重く見るかを、同じモデルのまま切り替えられる」パラメータとして説明されています*2。モデルを変えずに「じっくり考えさせる」か「さっと答えさせる」かを選べるつまみだと考えると分かりやすいです。
大事なのは、effortが思考の部分だけでなく、回答の文章やツール呼び出しも含めた出力トークン全体にかかる点です*2。effortを下げるとツールの呼び出しも少なく短くなります。また、effortは厳密な上限ではなく「振る舞いの目安」なので、低い設定でも難しい問題ならそれなりに考えます。
| 段階 | 公式の説明(要約) | 向いている仕事 |
|---|---|---|
| Low | 一番効率がよい。トークンを大きく節約し、性能は少し下がる | 単純な作業、速さと安さを優先したい処理、サブエージェント |
| Medium | 速さ・費用・性能のバランス型 | 速さと品質の両方がほしいエージェント処理 |
| High | よい結果のために必要なだけトークンを使う | 複雑な推論、難しいコーディング、エージェント処理 |
| Xhigh | 長時間の作業のための拡張設定 | 30分を超える長いエージェント・コーディング作業 |
| Max | トークンの消費量を気にせず性能を出し切る | 最も深い推論が必要な仕事 |
Fable 5.2とOpus 5.5はどちらも5段階すべてに対応しています*2。ChatGPTやGeminiなど他社のAIにも似た設定があり、各サービスでの呼び方や切り替え方は、以下の記事で解説しています。
AIの「Effort」設定とは?ChatGPT・Claude・Copilot・Geminiで処理の深さを使い分ける方法
今回の発表は、最高点だけでなく「どのeffortでどこまで届くか」を細かく出しているのが特徴です。公式発表の本文に書かれている数字を表にまとめました。
| ベンチマーク | Fable 5.2の設定 | 結果 | 比較とコスト |
|---|---|---|---|
| FrontierCode 2.0(コーディング) | High | 45.3% | Opus 5.5の最高点45.5%にほぼ並び、1タスクのコストは約半分 |
| FrontierCode 2.0(コーディング) | Xhigh | 49.1% | リリース済みモデルで最高。Fable 5.1は32.4% |
| Humanity’s Last Exam(ツールあり) | Low | Opus 5.5の最高点67.7%に並ぶ | 1タスクのコストは10分の1未満 |
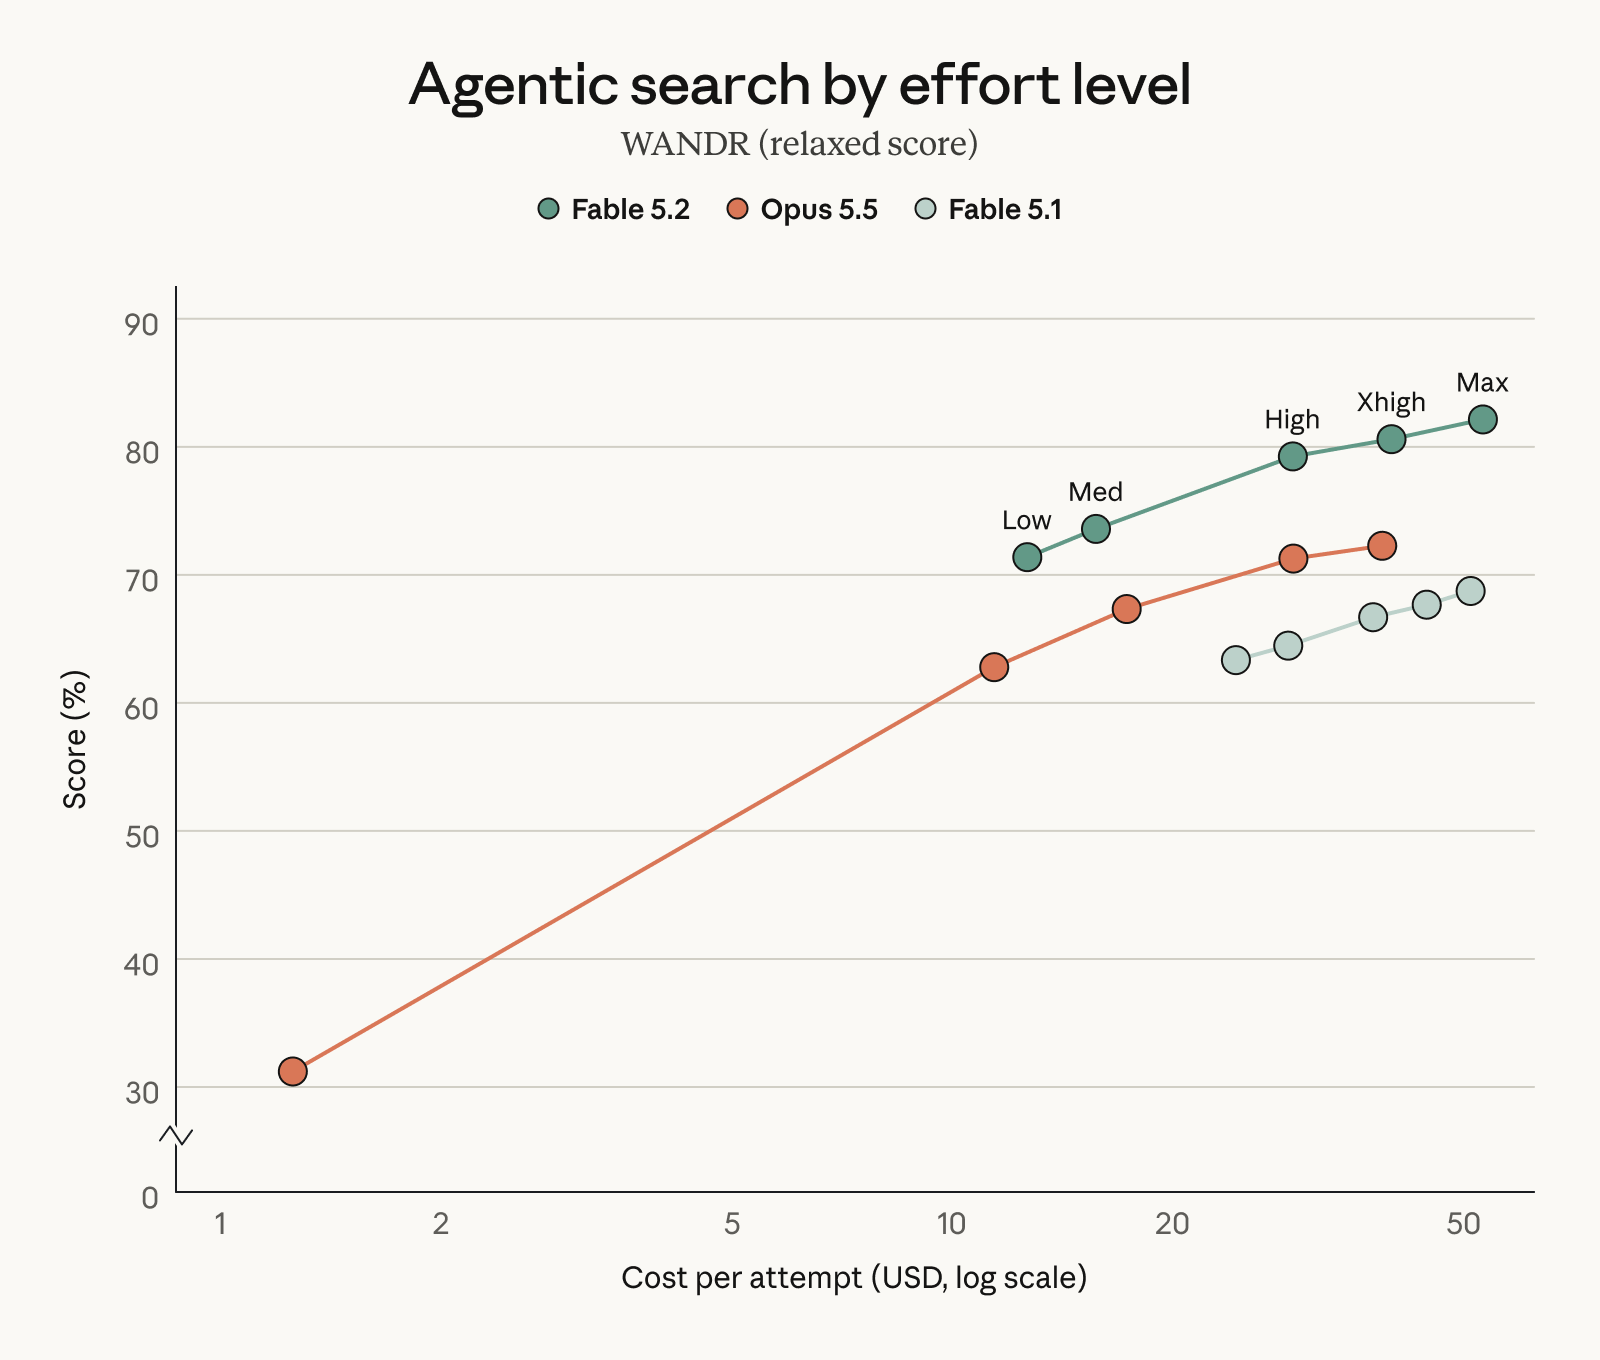
| WANDR | Medium | Opus 5.5の最高点に並ぶ | 1タスクのコストは約40% |
| Chartography(ツールなし) | Medium | 66.4% | Opus 5.5のMaxは64.4% |
数字はAnthropicの公式発表から引用しています*1。どのベンチマークでも、Fable 5.2はOpus 5.5の最高設定より低いeffort(LowやMediumでも)で、同じくらいの結果を出すという形になっています。
FrontierCode 2.0で公式発表に示された最高点は、Xhighの49.1%です*1。公式ドキュメントもFable 5.2について「能力の伸びの大半はHighの時点で出ていて、それより上の伸びは仕事によってばらつく」と書いています*2。さらにMaxは「トークンの費用を考えずに性能だけを追う設定で、Xhighより遅く高くつき、伸びは小さいことが多い」とされています*2。
考える量を増やしても、問題によっては答えの質がそれ以上よくならない、ということです。Anthropic自身も、Maxは「モデルの限界を測るときと、時間とトークンを気にしなくてよいまれな仕事」のために取っておくよう勧めています*2。
Fable 5.2のほかのベンチマーク結果(ロボット操作の64.9%など)は、以下の記事で解説しています。
ベンチマークとは?Claude Fable 5.2のロボット性能64.9%|Opus 5.5と比較
ここは見落としやすいポイントです。同じFable 5.2でも、使う場所によって既定のeffortが違います。公式発表では、ClaudeのアプリとClaude Codeの既定はMediumです*1。一方、APIでFable 5.2を呼ぶときの既定はHighです*2。
| 使う場所 | Fable 5.2の既定 | Opus 5.5の既定 |
|---|---|---|
| Claudeアプリ(Web・デスクトップ・モバイル) | Medium | — |
| Claude Code | Medium | — |
| Claude API | High | Medium |
APIでは、リクエストの output_config.effort に low から max のどれかを入れます*2。何も入れなければモデルの既定値になります。Opus 5.5のAPIの既定はMediumで、Opus 5以前の既定Highより1段低い点にも注意が要ります*2。Opus 5からモデル名だけ変えて移行すると、気づかないうちに考える量が減ることになります。
Fable 5.2とOpus 5.5は、メッセージごとにeffortを変える機能にも対応しています(ベータ)*2。プロンプトキャッシュを保ったまま切り替えられるので、調べものはLowで済ませ、設計の判断だけHighに上げる、といった使い方ができます。
最後の点は公式ドキュメントでも強く勧められています*2。また、effortを変えても回答の長さはほとんど変わらないため、短く答えてほしいときはプロンプトで指示する必要があります。Claude Codeで実際にOpus 5.5とFable 5.2を動かした比較は、以下の記事で解説しています。
Claude Codeとは?Opus 5.5とFable 5.2を実測比較|料金・使い方・活用事例
effortは料金表の単価を変えません。変わるのは使うトークンの量です。ここで面白いのが、Fable 5.2とOpus 5.5の単価の関係です。
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) |
|---|---|---|
| Claude Fable 5.2 | 8ドル | 40ドル |
| Claude Fable 5.1 | 10ドル | 50ドル |
| Claude Opus 5.5 | 4ドル | 20ドル |
| Fable 5.2 ファストモード | 16ドル | 80ドル |
Fable 5.2の単価はFable 5.1から2割下がりましたが、それでもOpus 5.5の2倍です*3。それなのにHigh設定のFable 5.2は、Opus 5.5の最高設定より1タスクの費用が約半分でした*1。単価が2倍で総額が半分ということは、同じ仕事をかなり少ないトークンで終えていると見られます。公式発表でも、Fable 5.2はMedium設定で難しい仕事をFable 5.1より少ないトークンで終えると説明されています*1。
つまり、モデル選びを「単価が安いほう」で決めると判断を誤ることがあります。単価×使うトークン量=1タスクの費用で比べることが大切です。ファストモードは生成が最大2.5倍速くなる代わりに単価が2倍になるので*5、急ぎの仕事に絞って使うのがよいと思います。
自社のシステムにClaudeを組み込むときは、どのモデルをどのeffortで呼ぶかで月々の費用が大きく変わります。法人向けAIリスキリングサービスの導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
公式の推奨とベンチマークの結果をもとに、私なら業務ごとに次のように決めます。あくまで出発点なので、自社の業務で試して調整してください。
| 業務 | おすすめのモデルとeffort | 理由 |
|---|---|---|
| メールの下書き・要約・翻訳 | Opus 5.5のLow〜Medium | 深い推論が要らず、速さと費用を優先できる |
| 議事録からの論点整理・社内文書の調査 | Opus 5.5のMedium、または Fable 5.2のLow〜Medium | Fable 5.2はLow〜MediumでもOpus 5.5の最高点に並ぶ結果がある |
| 難しいコードの修正・設計レビュー | Fable 5.2のHigh | Opus 5.5の最高点並みで1タスクの費用は約半分 |
| 数十分以上かかる自律的な開発作業 | Fable 5.2のXhigh | 公式も長時間のコーディング・エージェント作業で勧めている |
| モデルの限界を確かめる検証 | Fable 5.2のMax | 日常業務では費用と待ち時間に見合いにくい |
なお、Anthropicは発表の中で「ほとんどのコーディングや知識作業はOpus 5.5から始め、範囲や難しさが必要とするときにFableやMythosに上げる」ことを勧めています*1。Fable 5.2はOpus 5.5の上位というより、難しい仕事をより安く速く終わらせるための選択肢と捉えるのがよさそうです。
Opus 5.5そのものの料金や、Opus 5.5でのeffortの選び方は、以下の記事で解説しています。
Claude Opus 5.5とは?料金・性能・effortの選び方と4モデル実機比較
最後の点は、Fable 5.2の製品ページのFAQに書かれています*5。一方で、不要なブロックはFable 5.1より約55%減ったと発表されています*1。セキュリティ診断などで使う会社は、事前に動きを確かめておくと安心です。
また、出力はFable 5.1より最大30%速くなったとされています*1。速くなった分を「もう1段上のeffortに回す」か「待ち時間の短縮に使う」かは、業務によって決めるとよいと思います。
私のおすすめは、まず既定の設定のまま使い、詰まった仕事だけHigh、それでも足りない長い開発作業だけXhighに上げるやり方です。「とりあえずMax」をやめるだけで、品質を落とさずに費用と待ち時間を減らせる会社は多いはずです。effortは一度決めて終わりではないので、モデルが変わるたびに自社の業務で試し直す習慣を、ぜひ今回から作ってみてください。
\AIを活用したノウハウが詰まった/
資料ダウンロードはこちら記事の検索結果をご案内します。詳しいご相談は担当者がお答えします